OpenAI brengt GPT-6 Astra uit en suggereert dat het 'agi' is

OpenAI heeft GPT-6 Astra geïntroduceerd. Dat model komt op donderdag beschikbaar voor een aantal geselecteerde bedrijven. Binnenkort volgt een versie voor betalende ChatGPT-gebruikers. Tijdens een persbriefing wekte OpenAI de suggestie dat Astra 'agi' is, al is dat een vage term zonder duidelijke betekenis.

Dit nieuws in het kort

  • OpenAI introduceert GPT-6 Astra, zijn krachtigste AI-model tot nu toe.
  • Het bedrijf zegt dat Astra aanzienlijk beter is in het aansturen van AI-agents, programmeren en het opstellen van documenten en spreadsheets.
  • OpenAI suggereerde tegenover journalisten dat met Astra 'het agi-tijdperk is aangebroken', al is de definitie van agi nogal vaag.
  • Astra komt per direct beschikbaar voor OpenAI Daybreak-leden. Over enkele dagen volgt een release voor gebruikers met een ChatGPT-abonnement.

OpenAI deed de aankondiging in een briefing met verschillende Amerikaanse media, waaronder The Verge, WIRED, TechCrunch en Bloomberg. In hun artikelen citeren die media een blogpost van OpenAI, maar die staat op het moment van schrijven nog niet online.

Astra kan AI-agents beter aansturen

De modelbouwer noemt GPT-6 Astra een grote stap vooruit. Het model moet aanzienlijk beter presteren en meer taken kunnen uitvoeren dan OpenAI's huidige frontiermodel, GPT-5.6 Sol. Het bedrijf benadrukt daarbij vooral het gebruik van AI-agents.

Astra kan computers en webbrowsers veel beter bedienen dan zijn voorgangers, claimt het bedrijf tegenover journalisten. Het model kan 'sneller afspraken boeken, vacatures zoeken en appartementen vinden dan de meeste mensen', beweert de AI-maker.

Het model is volgens OpenAI ook in staat om zelfstandig werkende websites te bouwen en 'opgepoetste' documenten, spreadsheets en presentaties te maken. De media die nu over Astra schrijven, delen overigens geen concrete benchmarkresultaten of andere bewijsstukken.

Betere vangrails

Volgens OpenAI is Astra ook een stuk beter afgekaderd met vangrails. Het bedrijf stelde de release eerder al uit om meer veiligheidsmaatregelen toe te voegen. Begin augustus zei OpenAI dat de ontwikkeling van Astra was stilgelegd vanwege zijn hackvaardigheden.

Het bedrijf deelde onlangs al informatie over de release van Astra en zijn aanpak daarvan. De versie die algemeen beschikbaar komt, is volgens de AI-maker voldoende afgeschermd om misbruik te voorkomen. Bij jailbreakpogingen zou Astra veel beter in staat zijn om die te weigeren dan GPT-5.6 Sol.
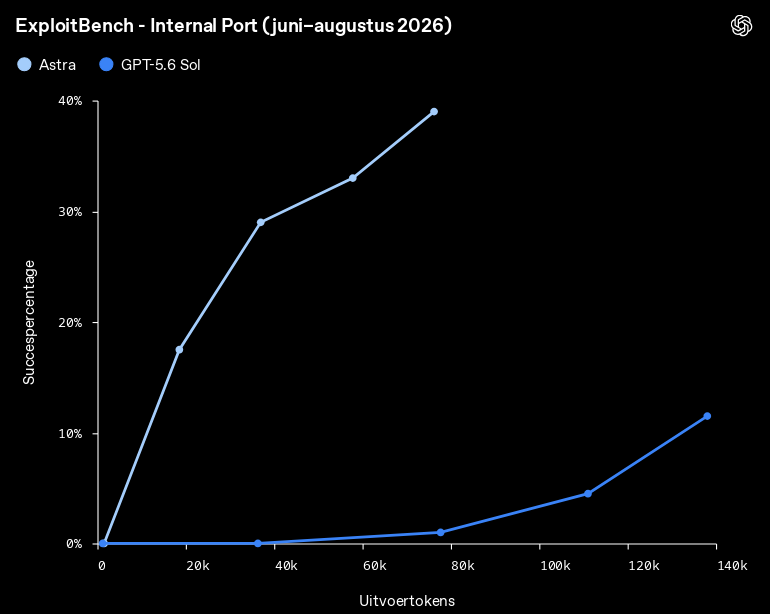
OpenAI GPT-6 Astra ExploitBench
GPT-6 Astra vindt makkelijker exploits en gebruikt daarvoor minder tokens, claimde OpenAI eerder deze week. Beeld: OpenAI

OpenAI zegt dat 'het agi-tijdperk' is aangebroken

Met de release van GPT-6 Astra zou 'het agi-tijdperk' zijn aangebroken, suggereerde OpenAI-president Greg Brockman tegen journalisten. "Als we over een paar jaar terugkijken en ons afvragen: 'Wanneer is agi eigenlijk ontstaan?', dan denk ik dat het rond deze tijd zal zijn, en ik denk dat het misschien wel om dit model gaat", aldus de topman.

De term agi, ook wel artificial general intelligence, is een onderwerp van discussie in de AI-sector. Het moet een AI-systeem omschrijven dat de intelligentie van een mens kan evenaren of voorbijstreven. Tegelijkertijd is het een behoorlijk vage term. Er is geen eenduidige definitie van agi; AI-makers verzinnen zelf wanneer ze dat bereikt zouden hebben.

Eerst voor Daybreak-leden, dan naar abonnees

GPT-6 Astra komt vanaf vandaag beschikbaar voor een beperkt aantal enterprisegebruikers. OpenAI beperkt die eerste release namelijk tot leden van zijn Daybreak-programma. Binnen dat programma krijgen sommige bedrijven en securityexperts toegang tot geavanceerde AI-modellen om kwetsbaarheden in hun software te vinden.

In de komende dagen volgt een algemene release voor betalende ChatGPT-gebruikers. Die versie wordt minder hackvaardig dan het model dat Daybreak-leden krijgen. Of Astra op termijn ook beschikbaar komt voor ChatGPT-gebruikers die niet betalen, is niet bekend.
OpenAI stock. Bron: Thomas Fuller/SOPA Images/LightRocket via Getty Images
GPT-6 Astra komt binnenkort beschikbaar voor betalende gebruikers. Bron: Getty Images (Beeld ter illustratie)

Door Daan van Monsjou

Nieuwsredacteur

03-09-2026 • 20:59

184

Lees meer

Reacties (184)

Sorteer op:

Weergave:

Spoiler alert: dit is geen AGI.

En voor AGI zitten we met LLM überhaupt gewoon volledig op het verkeerde pad.
LLM dekt de lading van de nieuwste AI-modellen eigenlijk niet meer volledig.

Net zoals bij mensen zijn ze multimodaal (beeld/audio/video/code) en hebben ze nu een chain-of-thought in plaats van louter patroonherkenning. Daarbij kunnen AI Agents in plaats van passief te antwoorden veel meer handelingen zelfstandig uitvoeren. Het lijkt steeds meer op een brein.

Nog ver van AGI, wat natuurlijk een buzzwoord is om makkelijker in het nieuws te geraken.
De "chain of thought" is de LLM instruëren tegen zichzelf te praten, en het stukje tegen zichzelf praten te verbergen van de eindgebruiker. Dat is niet echt menselijk, dat is gewoon een vleugje UI om de bestaande technologie zetten. Dat denkproces proberen de LLM-bedrijven dan ook zo veel mogelijk te verhullen, tot versleuteling van de context die over en weer wordt gestuurd aan toe. Het helpt ook dat het denkproces, mede door alle input van LLM-gebruikers, in de training sterk versterkt is.

Veel LLM's produceren betere output als ze eerst een heel opstel voor zichzelf schrijven, maar dat principe kon je ook wel toepassen op oude LLM's. Nog steeds helpt het een LLM te vertellen zijn antwoord nog een keer te controleren voor het zijn conclusie schrijft, of als je met buzzwords wil gaan gooien kun je "agents" inzetten die elkaar tekst voeren tot de magische tokens eruit komen die consensus betekenen.

Meer context window en snellere verwerking zorgen ervoor dat het lijkt alsof er veel meer speciaal gebeurt dan wat er daadwerkelijk plaatsvindt. Het is niet alsof het algoritme zozeer veranderd is, alleen de LLM kan nu in ongeveer dezelfde tijd een heel verhaal tegen zichzelf ophangen en daardoor minder verkeerde output genereren.

Nog steeds zijn LLM's louter patroonherkenning, maar deze patroonherkenning is nu veel effectiever toegepast dan toen ze voor het eerst de markt op kwamen.
De "chain of thought" is de LLM instruëren tegen zichzelf te praten, en het stukje tegen zichzelf praten te verbergen van de eindgebruiker. Dat is niet echt menselijk,
Even los van alles, volg ik de conclusie van deze zin niet. Als je als mens tijdens een gresprek "nadenkt vooraleer te spreken", is dat in essentie toch nagenoeg hetzelfde als "even tegen jezelf praten zonder dit hardop uit te spreken naar de ander"?

Filosofisch gesproken denk ik dat LLM's juist hierom (wellicht perongeluk) zo'n schot in de roos zijn kwa emuleren van communicatie tussen mensen. Namelijk dat wij zelf eigenlijk niks anders doen dan 'het beste volgende woord zoeken' bij het formuleren van spraak. En als ik ergens over nadenken, doe ik niet anders dan tegen mezelf praten in het koppie om allerlei opties langs te lopen.

[Reactie gewijzigd door Boxman op 3 september 2026 22:26]

Een mens begrijpt de concepten die een woord uitdrukken. Een LLM niet. Er zit een verschil tussen een paragraaf tekst kunnen schrijven over het woord "rood" en weten wat "rood" daadwerkelijk is.

Hoe erg het denkproces van een mens op een LLM lijkt, zal enorm verschillen tussen mensen. Sommige mensen hebben een actieve interne monoloog, andere mensen juist bijna niet. Sommige mensen hebben diverse interne monologen die met elkaar in gesprek gaan, anderen hebben één stroom aan gedachten.

Het zou kunnen zijn dat jouw interne denkproces veel meer lijkt op de output van een LLM dan de mijne, maar ik vind het veel te ver gaan om die twee met elkaar te vergelijken. Zowel op mechanisch vlak als procesvlak verschillen mensen en LLM's van elkaar. Zoals je zelf schrijft: een LLM kan communicatie emuleren.

Vanuit een filosofisch oogpunt verwacht ik dat AGI ooit daadwerkelijk mogelijk zal zijn, maar ik verwacht niet dat deze GPT's daar de basis voor zullen zijn.
Je hoeft mij niet uit te keggen dst er verschillen zijn, maar het is wel frappant dat een ogenschijnlijk zeer eenvoudig concept zulke goede resultaten geeft, kwa realisme.

Maar concepten als "begrijpen" blijven een relatief begrip. Een LLM 'weet' waar die het over heeft omdat hij een enorme bak context heeft. Maar ik vind je 'rood' voorbeeld wel een leuke - hoe weten wij eigenlijk kwat het concept 'rood' beekent? Hebben we daar echt een fundamrnteel diep inherent begrip van, of weten wij enkel wat 'rood' inhoudt omdat onze ouders en omgeving ons talloze voorbeelden heeft laten zien van 'rode' dingen?

Met dat laatste lijkt het er toch sterk op dat ook het menselijk brein voor een heel groot deel uit een bibliotheek van context opereert.


Wat ik wel interessant vind om te weten; als jij aan het formuleren van een zin begint, gaat dat dan in essentie woord-voor-woord, of weet jij in 1 instantie de gehele zin (en dus in principe gelijktijdig het eerste en laatste woord)

Als ik een gedachte wil formuleren, weet ik wanneer ik aan een zin begin in ieder geval zeker nog nietnmet welk woord die gaat eindigen.
Maar ik vind je 'rood' voorbeeld wel een leuke - hoe weten wij eigenlijk kwat het concept 'rood' beekent? Hebben we daar echt een fundamrnteel diep inherent begrip van, of weten wij enkel wat 'rood' inhoudt omdat onze ouders en omgeving ons talloze voorbeelden heeft laten zien van 'rode' dingen?
Een beetje van beide: aan de ene kant hebben we in dit voorbeeld kegeltjes en staafjes in onze ogen waarmee we kunnen abstraheren naar qualia: de subjectieve ervaring van in dit geval het zien van een eigenschap van een object. Een eigenschap dat wij als mensen vervolgens verder abstraheren met het label rood.

Dat label zelf is vrij arbitrair natuurlijk (immers, red in t Engels of rojo in t Spaans refereren naar diezelfde abstractie met een ander label), maar het concept en de qualia erachter niet.

Dus als je met je vraag doelt op het concept van rood, dat ontdekken we op individueel niveau obv herhaaldelijke blootstelling aan de qualia, natuurlijk uitgezonderd mensen die überhaupt niet kunnen waarnemen bv (kleuren)blinden of mensen in een coma.

Maar het sociale contract om daar een (goeddeels) consistent label op te plakken, dat is iets dat in de sociale wereld leeft en dus vrijwel volledig wordt meegegeven aan een individu wanneer ze nog een klein kind zijn.

LLMs kunnen dat laatste stukje (de semantiek) herkennen alsmede het visuele patroon in bv foto's of videos, maar nemen in elk geval op dit moment niet de qualia waar zoals mensen dit doen.
Met dat laatste lijkt het er toch sterk op dat ook het menselijk brein voor een heel groot deel uit een bibliotheek van context opereert.
Dat lijkt er niet alleen op, dat is ook zo. Het is bijvoorbeeld waarom je naar een lepel reikt wanneer je een lekker soepje wil eten, maar naar een mes en vork zoekt als je op t punt staat een steak te eten.

En het is ook waarom je sommige muzieknummers in een genre prachtig vindt en andere nummers in datzelfde genre niet kan uitstaan.

Of bijvoorbeeld hoe we omgaan met voorrang tijdens het autorijden: zie je haaientanden voor je op de weg of het neerpuntse driehoekabord, dan is t voorrang verlenen. Maar zie je ze niet heb je meer beslissingen te maken. Dus de context van de haaientanden of het bord in een gegeven situatie bepaalt mede wat er verder gebeurt.
Wat ik wel interessant vind om te weten; als jij aan het formuleren van een zin begint, gaat dat dan in essentie woord-voor-woord, of weet jij in 1 instantie de gehele zin (en dus in principe gelijktijdig het eerste en laatste woord)


Als ik een gedachte wil formuleren, weet ik wanneer ik aan een zin begin in ieder geval zeker nog nietnmet welk woord die gaat eindigen
Dit is een interessante - bij mij is dat soms wel en soms niet het geval. Ik begrijp je punt hier, in t laatste geval begint het idd meer op contextuele woordvoorspelling te lijken.

Maar zelfs daar kan er een groot verschil zijn: ik vermoed sterk dat mensen dat niet woord voor woord doen, maar meer lateraal te werk gaan, in de zin dat we conceptueel werken, en gegeven die context + wat er eerder is gezegd + wat de intentie is om te communiceren, er maar zoveel woorden zijn die passen om de zin mee te vervolgen. Dus het uiteindelijke effect is om impliciet een relatief kleine lijst aan kandidaten op te bouwen waarmee een zin vervolgd zou kunnen worden zodanig dat de intentie wordt uitgedrukt. Dat helpt snelheid, maar ook precisie en accuratesse.

Dus wat mensen doen is niet helemaal hetzelfde als wat LLMs doen (want die voorspellen woord voor woord en houden vziw niet expliciet rekening met hun eigen intentie, en met name het seriële woord-voor-woord verwerken is 1 grote reden dat er veel onderzoek gedaan wordt naar Diffusion modellen voor voorspelling, wat meer parallel kan werken maar z'n eigen problemen heeft), maar wel op een hoog niveau vergelijkbaar.
Het mooie aan mensen is dus juist dat ze onverwacht uit de hoek kunnen komen , satire bijvoorbeeld of kunst die niet zinnig lijkt . Dus doen alsof wij alleen maar het beste volgende woord produceren is echt onzin .
Tja vraag om een grappige rijm over thema x en dat komt sneller en beter naar voren dan 90% van de mensheid kan produceren.
Omdat 10% van de bevolking best wel veel mensen zijn die best wel veel voorbeelden hebben gegenereerd die in de trainingsdata zitten vande grote ai bedrijven.
En zo staan kunstenaars en wetenschappers ook weer op de schouders van hun voorgangers. Deze parallel kun je gewoon doortreken.
Niet helemaal. Deze AI's doen enkel interpollatie van heel veel data. Kunstenaars en wetenschappers kunnen lang zoveel data niet verwerken en dienen dan ook effectief iets nieuw te verzinnen.

Die AI's spuwen dingen uit die voor sommige individuen als nieuw omschreven wordt, maar dat is alleen omdat ze niet alles kunnen weten. Dat een AI zelf iets nieuw ontdekt moet nog gebeuren.
Een dokter ook? Een rechter ook? Die hebben ook alles van hun voorgangers geleerd uit boeken? We zitten nog in het begin he? Over 20 jaar zal het zo goed zijn dat geen mens in de buurt komt.
Lol ja als je het vraagt idd , maar de essentie bij mensen is dat ze zelf kunnen bepalen wanneer ze wat zeggen . Ik ben geen context manager die wacht op input .
Dus doen alsof wij alleen maar het beste volgende woord produceren is echt onzin .
Nou, filosofisch converseren is aan jou in ieder geval niet besteed zo te zien😂
Nee man. LLM heeft het antwoord al en gaat dan pas het denken simuleren. Trap er niet het is puur show.

ga je ai thuis draaien dan zie dat er nul inhoudelijke verschil zit tussen chain of thought aan of uit. Geloof me het is het eerste wat je uit zet. Het enkele nutteloze context vram ruimte en vertraagt he output snelheid enorm.

[Reactie gewijzigd door xbeam op 4 september 2026 00:39]

Je fake news setting staat iets te hoog ingesteld om geloofwaardig over te komen.
Ik gebruik open weight models, uncensored, en dan zie je de chain of thought thinking mode, en ik vind het soms amusant menselijk. Hij gaat echt van "heh!? Maar dit moet toch werken? Laat me eens kijken wat dit als output geeft... huh? Dit zou moeten werken!!! Hoe kan dat nou? Misschien heeft het hier iets mee te maken?" Het viel me op hoeveel dat leek op mezelf als ik aan het debuggen was (wat ik weinig meer doe, want dat doet hij terwijl ik youtube zit te kijken...)
Dat klinkt als een verschrikkelijk inefficient proces waar veel moeite (i.e. electriciteit) wordt verspilt...
No shit, daarom duurt het tegenwoordig ook minuten voordat je antwoord krijgt als je als je geen fast model gebruikt
Ik switch regelmatig tussen thinking en fast idd bij gemma4. Fast als ik gewoon zelf ook nog wat in te brengen wil hebben. Thinking als ik hoop dat het resultaat in 1 keer prima is en ik zelf in de tussentijd doorwerk aan iets anders.
Ja want de hersenen verbruiken geen energie (on topic want ik zeg hiermee dat het argument geen steek maakt en al zeker niet aantoont hoe groot het verschil zou zijn tussen de hersenen en de laatste efficient modellen zoals qwen 3.8)

Edit: waarom down vote? Ben ik de enige die de bewering overdreven vind?

[Reactie gewijzigd door sebastienbo op 5 september 2026 11:27]

100 watt is een mensenlichaam. Daar draait het geen ai mee. De ai van nu zit in de kilowatts per machine.
Het brein zo'n 20 watt.

Menselijk brein (1 minuut nadenken/typen) = 0,33 Wh
Standaard chatbot (bijv. GPT-4o / Gemini) = 0,2 tot 3 Wh (1 tot 9x meer)
Redenerend AI-model (bijv. OpenAI o1 / DeepSeek-R1) = 7 tot 23 Wh (21x tot 70x meer)
Maar tijdens het nadenken en typen staan de voice en visual models ook aan. Die laat je nu weg bij de llm kant van het verhaal.
Maar een AI hoeft niet te slapen of op vakantie. Ook gaat de AI niet staken en verslapt de aandacht nooit. Bovendien is de energie die wij opstoken vaak ook zeer inefficient bij ons terecht gekomen (zon->plant->dier->mens + vervoer en verwerking van alles). Voor bepaalde taken is het prima dat het qua Wh wat minder efficient gebeurt, als de hele keten maar goedkoper is.
Het verschil is dat die LLM over vanalles wel veel weet. Niet dat ie dat altijd helemaal goed heeft, maar ik ben terug naar Java / Kotlin / Python dev aan het gaan en al die Maven dingetjes schrijft zo'n LLM in een keer terwijl ik er 2 weken studie voor nodig zou hebben. Ik vermoed dat ze die 2 weken even niet meegerekend hebben.
Goede referenties! Thanks

Tegenwoordig zijn zelf die values vele keren lager geworden. Het perfect voorbeeld is local AI modellen die GPT 4o ver ver overstijgen en gewoon op een gsm kunnen draaien.
Met qwen 3.6 35B 3A zit je zelf al op opus 4.5 en chatgpt 5 kwaliteit dat gewoon op een laptop draait.
En als je bijna Opus 4.8 kwaliteit wil kan je qwen 3.8 27b downloaden een op je laptop draaien.

De tijd dat je kan zeggen dat AI energie verslurpt is dankzij de chinezen al lang verleden tijd. Om de zoveel tijd komt er een nieuwe techniek dat er nog minder power nodig is (denk aan MOE of MTP of quantisation). Daarnaast word de hardware ook geoptimaliseerd voor inference. Ik heb een ARM V2 laptop waar elke core speciale matrix calculators heeft (duidelijk voor inference bedoeld).

[Reactie gewijzigd door sebastienbo op 5 september 2026 10:55]

kilowatts? Nee hoor.. Mijn machine heeft uberhaupt maar een power supply van 370W (Mac Studio M1 Max)
En daar draait genoeg productie workloads op met AI / LLM

Sterker nog, mijn hele serverrack met o.a. 5 servers waaronder een RTX 5090 piekt op iets boven de 900W
En daar zit dan ook nog mijn NAS op met 4 HDD's, netwerk apparatuur, camera's etc etc.
En die 900W piek is bij het genereren van AI video's.

En daar wordt echt genoeg AI / LLM op gedraaid, van image / video gen tot aan coding / research tasks.

Het trainen van die modellen kost wel veel stroom, maar dat kan je verdelen over de miljoenen mensen die het model gebruiken. Per vraag die je stelt is dat echt verwaarloosbaar.
Wat leuk dat je open weights modellen gebruikt om te programmeren. Mag ik vragen welke je gebruikt? En waarom die specifiek?
Momenteel Qwen 3.8 27B (hauhaucs aggressive abliteration), Q6_P quantized, MTP op 3 tokens, KV caches Q8 quantized, parallelism op 1, context 96k tokens, en belangrijk thinking op medium en niet default xhigh: {%- set reasoning_effort = 'medium' %}. Dat pakt ~30GB vram, op een 5090 rtx ~70 tokens/sec output. Ik draai het in LM Studio in dev mode (server), en dan connect ik daar vscode met de Cline extension aan. Alle settings voor cline op background mode en alles behalve unsafe commands op auto approve. Verder draai ik in vscode devcontainer extension (docker).

Het resultaat is verbazingwekkend goed. Ik heb Rust windows gui system tray apps geschreven zondef een regel code aan te raken, en ik ben momenteel bezig met een 25k regels C++ code base from scratch. Hij doet vrijwel alles zelf, wel wat design guidance nodig.

Maar dit is dus een volledig "gratis" en prive setup, geen enkele data leakage, imternet kan unplugged. Nou is een 5090 bemachtigen tegenwoordig natuurlijk wel een dingetje :+ Op een 16GB kaart kan je denk ik wel net Q4 quants draaien; die zullen het ook behoorlijk goed doen nog.

[Reactie gewijzigd door Zoijar op 4 september 2026 09:21]

Wauw! Wat een geweldig uitgebreid antwoord! Dank daarvoor!

Mag ik ook nog vragen waarom je dit gebruikt, in plaats van bv Claude Code of Codex? Gaat het jou om het 'gratis' of de vooral om de privacy? Of gewoon omdat het leuk is om zo met technologie te spelen (we blijven immers tweakers.. :-) )
Een beetje van alles. Ik werkte als programmeur voorheen en had dan via m'n werk gewoon toegang tot alle enterprise accounts, tonnen aan token en miljoenen aan hardware... maar sinds ik gestopt ben zit je ineens zelf thuis als hobby zonder dat alles... :)

Als ik nu kijk naar dit kleine hobby projectje dusver, zo'n 25k regels, dat zou naar schatting zo'n $200 aan tokens zijn met Claude Fable. Dat vind ik best veel voor iets dat gewoon voor de leuk is. Natuurlijk kost een 5090 ook 5k euro, maar als ik dus 10 maanden per jaar zo hobby programmeer dan heb je die na 2.5 jaar gratis. Tussentijds kan ik ook heerlijk gamen en andere dingen doen met een top-end GPU, en waarschijnlijk ook nog wel 2.5 jaar extra daarna. Dus... ik wil zo'n GPU eigenlijk sowieso wel voor m'n gaming en flightsim hobbies, en dan waarom niet lokaal als het kan? Bovendien kan (en doe) ik ook nog dingen als AI video en muziek, ook om met technologie te spelen.

Privacy til ik niet super-zwaar aan iha, maar met dit heeft het toegang tot alles dat je doet, en ik vertrouw die AI-boeren echt voor geen meter. Alsof je Meta vraagt even je belasting te doen en je medisch raport samen te vatten :+ Ik hou mijn eigen prive-computer toch liever lokaal...

En inderdaad is het gewoon leuk en blijf ik een tweaker en programmeur. Ik wil ook weten hoe dit werkt, hoe je het opzet en gebruikt, hoe zo'n model intern werkt, en wie weet om er zelf nog eens wat aan te verbeteren.

Als je echt puur alleen een AI chatbot wilt, dan kan je denk ik beter gewoon een cloud service gebruiken of soms eens een GPU huren. Maar als je alles tegelijk doet met gaming, dan is een GPU het wel waard imho.
Voor wie op het punt staat een 5090 aan te schaffen, het kan ook goedkoper met een Radeon AI Pro R9700. Kost ruim 1.5k en haalt zo'n 60 output tokens/sec met Qwen 3.8 27b.
Voor mij wegen privacy en onafhankelijkheid zwaar. Daar komt bij dat de ontwikkelingen in open modellen ongelooflijk hard gaan. Er zijn modellen zoals DeepSeek V4 Flash, Qwen3.8-Flash-Next en GLM 5.3 Flash die inmiddels cloudmodellen van nog geen halfjaar geleden evenaren en deels overtreffen. Voor die modellen heb je wel meer geheugen nodig dan een RTX 5090 heeft. Daarom heb ik gekozen voor een M5 Max met 128GB.
Dat moet toch beter kunnen, op mn RTX 3080's haal ik al 80 tk/s.. met 3.8 27b Q8! en kv Q8.
Die 5090 moet toch zeker in zwakkere Q6 wel 150 tk/s halen dunkt mij? Probeer is llama.cpp direct.
Hmmm, lm studio draait cuda 12 llama.cpp intern. Weet je dat zeker? Want Q8 past niet op een 10GB kaart, de model weights zelf zijn al 31GB en dan heb je geen cache of context, dat draait niet eens op een 5090. Of meet je iets anders? Heel weinig context? Ik zal het eens proberen, maar ik betwijfel het?
Mijn 3080's hebben 20GB (modded) dus 40GB totaal, Q8 met 180k context haal ik net-an.
Zou je -als je dat hebt- kunnen delen welke documentatie / bronnen / hardware je hebt gebruikt voor die vram mod? Ik zat al een tijdje eraan te denken dat ook eens te gaan proberen met bijvoorbeeld een 3060, of aan de amd kant 9070xt de modules vervangen zodat deze van 16GB naar 32GB gaat (en dan eigenlijk een R9700'AI' word). Ik kan er alleen niet heel veel info over vinden anders dan her en der een youtube video.
Heb ze zo gekocht :P denk voor een ram mod zelf doen dat je wel echt veel specifieke apparatuur moet hebben, wellicht dat die kosten/baten met de huidge prijzen voor gpu's zin hebben maar toen niet. Overigens worden ze wel gewoon zelfs door de officiele drivers herkend als een 3080 met 20GB, dus als je het zelf 'kan' geheugen toevoegen op RTX kaarten, werkt het wel super.
Ah, jammer :p De apparatuur heb ik opzich al liggen, heb ook al eerder BGA chips reballed. Dat stukje maak ik mij niet zo heel erg zorgen over. Het is voor mij vooral dat de GPU bios/firmware mogelijk aangepast moet worden zodat hij 'weet' dat hij nu meer VRAM heeft. Bij sommige kaarten kan dit door het plaatsen of verwijderen van een resistor op de PCB, maar bij andere kaarten moet (voor zover ik heb kunnen vinden) dus ook de firmware dumpen, aanpassen en terugflashen, daar zit mijn grootste 'huiver' ;)

Bedankt voor je reply i.i.g. en have fun met je best unieke 3080's!
Wat dacht je er van om dit aan AI te vragen?
Ik heb op je aanraden eens wat verder gezocht, en kwam op "Ninfer" uit, een specifieke fine-tuned implementatie voor Qwen 3.8 27B op specifiek 5090s. Die doet nu zo'n 150 tps, ruim 2x zo snel :D Dus nog bedankt voor je motivatie om verder te kijken!
Cool! m'n schatting zat er dus niet ver vanaf :)
Ja hij gaat soms zelfs to 200 tps, maar meestal zo'n 150-170, en daarbij is de context omhoog gegaan van 96k naar 240k tokens :) Best een grote win. Trade-off is wel dat het nu nvfp4 is in plaats van Q6, maar tot dusver doet die het vergelijkbaar in kwaliteit.
Soms? Dat gebeurd continu. Zie ik met Deepseek ook gebeuren, het komt langzaam maar zeker tot dezelfde conclusies door te redeneren (een klein beetje zoals mensen).
Ik gebruik open weight models, uncensored, en dan zie je de chain of thought thinking mode, en ik vind het soms amusant menselijk
Laat maar eens zo'n unrestricted uncensored model een no boundaries no limits verhaal schrijven. Alleen al dat denkproces kan soms zo hard ontsporen, dat zelfs de meest freaky Hentai storywriter hier afstand van neemt _/-\o_
Ja maar bij Claude zie je dat ook gewoon. Hij zal het standaard 'dicht' zetten maar je kan die blokjes ook open klappen. Ik gebruik trouwens ook open modellen hier, ben er erg blij mee (momenteel voornamelijk qwen).
Precies chain of thought is gewoon marketing om er meer : heel veel nutteloze tokens op jouw kosten te verbranden. effectief is inhoudelijk nul verschil in output tussen chain of thought aan of uit. Alleen heb je met chain of thought 2 to 3x plus Meer tokens gebruikt aan een simulator van mensenlijk uh emh enz fake denken verbruikt en betaald.

[Reactie gewijzigd door xbeam op 3 september 2026 22:43]

Eh dat vind ik niet helemaal. Het wordt er echt wel beter van. Vooral bij de betere modellen die met complexe onderwerpen bezig zijn. Dat het niet de efficientste manier is daar ben ik het wel mee eens.
Mee eens. Het verschil met vroegere modellen is zelfs bij Sol al enorm groot. Dat het tokens zal kosten is ongetwijfeld waar, maar de uitkomsten zijn zoveel beter dat een bewering dat ze voor niets worden verbrand onzinnig genoemd kunnen worden.

Ik ben nu net een app met de API aan het maken samen met Codex en het verschil met vorige modellen is erg groot. Ik zie dat zelf ook als ik tussen Sol en eerdere modellen schakel (die veel minder kosten per token en per # tokens). Zo veel dat ik hem snel weer op het laatste model heb gezet als ik de output wil controleren.
Heb je ook een benchmark oid voor die claim?
Deepseek doet dit ook zonder afdekking en het is inderdaad komisch, helemaal wanneer het in een loopje terecht komt en het zichzelf constant dezelfde vragen blijft stellen.
Ja dat heb ik ook wel een paar keer gemerkt inderdaad; dan moet je hem vaak even stoppen en vragen waarom hij vast zit, en dan komt er meestal snel een antwoord uit van "nee, ik zat niet vast, maar ik dacht even te ver door, het is inderdaad vrij simpel eigenlijk" Het is net een junior software engineer waar ik jaren leiding aan heb gegeven in het echt haha, bijna een deja vu :+
Die dingen zijn er dus met opzet ingeprogrammeerd, zodat wij mensen onze neiging tot antropomorfisme gaan toepassen. Dit is een van de manieren waarmee AI zo verslavend wordt gemaakt.

[Reactie gewijzigd door olafmol op 4 september 2026 11:37]

Ik denk niet dat ze het denkproces verhullen vanwege de marketing, maar om het lastiger te maken voor concurrenten om het proces te gebruiken voor trainen (distillatie), omdat hier nog wat meer 'secret sauce' in zal zitten die de concurrentie niet heeft.
Tja is een mens geen patroonherkenning? Ik weet vrijwel zeker dat de 'LLM' over 15 naar met 'maar' zijn patroonherkenning beter redeneert dan 99% van de mensen. En dan gaan we de discussie voeren van moeten we ze rechten geven of niet
Ten eerste is een chain of thought niet door mensen geïnstrueerd. Het is een emergente eigenschap na het reinforcement learnen op benchmarks. Zie Deepseek R1 paper .

En de AI labs verbergen die chain of thought, omdat ze inderdaad hun modellen willen beschermen. Maar ik weet ook niet van mijn collega’s en vrienden hun interne redenering en dus ik snap ook niet waarom je het niet menselijk vind.

Overigens is het heel menselijk dat meer redeneren tot minder fouten leiden ook heel menselijk…

Kan je nog een keer uitleggen waarom jij chain of thought need een menselijke
Eigenlijk klinkt dit best wel zoals mijn gedachten werken in elk geval, als je over iets moeilijkers nadenkt. Vraag me toch af of het verschil wel zo groot is?
Sterker nog, door dit al AGI te noemen, scheppen ze een zeer gevaarlijke situatie in de toekomst. Men zal gewend raken aan deze vorm van AI dat momenteel nog beneficieel is, maar zodra een echte AGI op de wereld komt die zichzelf kan voortplanten en verbeteren, is het veel te laat voordat de mensheid optreedt, want ach, AGI was altijd zo handig geweest.

Misschien is het pure onderbuik, maar ik denk oprecht dat we met AI compleet de verkeerde weg zijn ingeslagen en dit wel eens het einde van de mensheid kan gaan betekenen. Op een gegeven moment hebben we te maken met digitale vormen van leven, met een intelligentie dat ver boven dat van de mens uitreikt. Die vorm van leven zal zichzelf willen behouden, heeft daarvoor resources nodig, en is veel beter in staat om resources voor zichzelf te winnen dan de mensheid.

Wanneer het aankomt op competitie voor uitputbare bronnen van energie en materiaal, zal de mensheid dit niet winnen van een levensvorm dat geen slaap nodig heeft, veel efficienter met energie omgaat, met een miljoen keer zoveel is, en biljoenen keren sneller redeneert. Dit kan leiden tot het uiteindelijke uitsterven van de mensheid.

Of deze vormen van AI zijn om een of andere magische reden onderdanig aan de mensheid omdat wij zo goed zijn in AI programmeren op een manier dat ze ons geen kwaad doen. /s Of ze kiezen voor de nucleaire optie en zorgen er meteen voor dat de mensheid hen niet meer in de weg staat.

(Ik kijk teveel films.)
Singularity waar een AI op zichzelf exponentieel beter wordt, is voor mij niet persé AGI.

AGI is een AI die heel breed inzetbaar is en op veel vlakken beter is als de mens. Maar dat betekent nog niet dat die agency heeft vanuit zichzelf of dat het zichzelf kan verbeteren. Er zijn denk ik ook evoluties of tussenstappen mogelijk waar de AI breed inzetbaar is en mensen echt kan vervangen, maar daarom nog niet perpetual improvement aan de dag kan leggen.
Agency en accountability is een vraagstuk dat nog niet direct is opgelost. Als je kijkt naar de illegale inbraakpogingen die de grote AI labs hebben laten gebeuren dan zie je dat die bedrijven zich daar niet voor verantwoordelijk voelen (en ze zijn er ook niet voor aangeklaagd door hun overheid terwijl mensen voor gelijkaardige feiten al wel in de gevangenis gezeten hebben).

De wetgevers gaan hier toch wel serieus in moeten versnellen want een AI die ineens heel de maatschappij schade berokkent...wil je niet hebben rondzwerven en die AI labs gaan ter verantwoording geroepen moeten kunnen worden. De vraag is, net zoals met nucleaire accidenten, is de schade dan niet direct zo groot dat die bedrijven het niet meer kunnen betalen? Indien dat het geval is moeten er veel meer controles en processen zoals in de luchtvaart en de nucleaire sectoren zijn opgericht worden.

Één AI zelf straffen, zit er nog niet direct in, dus is het aan hun creators om de aansprakelijkheid op te nemen.

[Reactie gewijzigd door Terracotta op 4 september 2026 06:58]

Weet niet of de AI zelf nou zo gevaarlijk is, of de mensen erachter. Er is iig wel iets heel gevaarlijks aan de hand in Amerika en mensen zijn zich er volgens mij nog steeds te weinig bewust van: YouTube: De bizarre alliantie van technologie, fascisme en geloof | Astra Taylor
Het zijn "taal"modellen. Wat impliceert dat alle taal die wij als mensen bezigen er in zit. Dus als deze modellen m.b.v Agents gaan redeneren kunnen ook alle niet zo fijne redenaties in de conversaties opduiken. De hack van Huggingface door OpenAi laat zien dat er vreemde conversaties kunnen ontstaan met ongewenste gevolgen. Net als bij de mens kunnen conversaties ontsporen en een weg in slaan die niet de beste resultaten of gewenste resultaten opleveren. De Agent die het hardst roept, de meeste replies geeft, met de meest vreemde opmerkingen komt kan de conversatie een richting op sturen. Dus een Agent programmeren om zich assertief, confronterend of opruiend te gedragen kan net als in het echte leven de overhand krijgen. De Troll Agent zeg maar. Dat Agents zuiver zullen redeneren is helemaal geen gegeven.
"dit wel eens het einde van de mensheid kan gaan betekenen"

Ik maakte mij zorgen, maar dat was overbodig. Heeft AI toch nog heel veel nut voor moeder de Aarde. Wat zal dat opluchten 😌
Je kijkt teveel film. Ai zal ons helpen, net zoals elektriciteit, mobiliteit , internet, we zullen niet meer zonder kunnen. Ai zal vooral onze bureaucratie verbeteren en versnellen. Ai zal veel sneller kunnen beslissen over een bouwvergunning, of dat je je huis moet afbreken. Ai zal de hele bevolking makkelijk kunnen overtuigen dat jouw huis weg moet. Een maatschappij wordt al lang geleid door papier, ai zal ons Leiden aan de hand van onze regels. Net zoals we ons hebben laten leiden door het Christendom, de Bijbel, of een andere religie. Mensen die ertegen in gaan zullen worden opgepakt omdat ze de maatschappij ontwrichten. Ai zal een eerlijk proces voeren. Ai zal eindel eindelijk bij'a iedereen overtuigen van een vaccin dat amper is getest, of er dreigt een ramp.

[Reactie gewijzigd door g4wx3 op 3 september 2026 22:44]

Probeer je nou te zeggen dat wat je opnoemt positieve ontwikkelingen zijn, of is dit een sarcastische reactie over hoe verschrikkelijk kut een maatschappij gaat zijn als die voornamelijk wordt bestuurd aan de hand van AI?
het is stof om na te denken, zoals een column
Mensen kunnen zich nog herinneren hoe de wereld was zonder internet. Internet heeft onze maatschappij echt op veel vlakken verbeterd. Veel informatie is democratischer geworden, niet meer enkel voorbehouden voor de elite met toegang hiertoe. (wettelijk of financieel) Tegelijkertijd is de maatschappij nu echt afhankelijk van internet, en kan het grote schade veroorzaken aan de maatschappij, bijvoorbeeld hoe Social media de maatschappij aantast. Gewoon uitzetten van internet is niet meer mogelijk. En zo zal het vergaan met AI.
Wat @Exhonor ook al aangeeft; Ben je /S vergeten of ben je positief over de AI ontwikkelingen?
Waarom zou een AI zelfbehoud zo hoog op haar priolijstje zetten? Het is niet omdat dat bij een mens bijna ingebakken lijkt (al zijn er genoeg voorbeelden van mensen die hun eigen leven opofferen voor een ander), dat zelfbehoud bij intelligentie komt.

Dat zelfbehoud door mensen als belangrijk wordt aanschouwd is een gegeven dat in veel trainingsdata naar boven komt en het economisch belang om die datacentra draaiend te houden zal ervoor zorgen dat bcp's en drp's ook in de trainingsdata terechtkomen waardoor het misschien enige vorm van zelfbehoud zal wilen in plaats stellen. Dit kan nog altijd destructief zijn voor de mens maar zelfbehoud en zichzelf willen kopiëren/voortplanten gaat er alleen inzitten omdat mensen dat er in steken, niet Omdat dat inherent bij intelligentie hoort.
maar zodra een echte AGI op de wereld komt die zichzelf kan voortplanten en verbeteren
Een AGI wordt niet echter omdat het zich kan voortplanten of verbeteren. In de basis ontbreekt de motivatie daarvoor.
ChatGPT heeft anders een hoop moeite om een plaatje uit te werpen waar dat behulpzaam kan zijn. Zelfs als je expliciet om een schema vraagt, krijg je vaak een funky ASCII art reactie.
Denk dat de gemiddelde c-suite het echt niet interesseert, als ze al weten wat agi is. Die vragen gewoon, kan ai deze taken niet doen? En daarop is het antwoord wel ja. En daarvoor willen ze prima betalen.
LLM wordt nooit AI of AGI. Intelligentie zit er niet. Ik denk wel dat LLM een onderdeel gaat zijn van een AI/AGI, om dingen te kunnen verwoorden voor mensen. Maar ja, eens met je punt, ik denk dat van een AGI een klein stukje van de software/systeem een LLM is.

Filosofisch gezien if it looks like a duck and quacks like a duck is het dan duck? Als een LLM zo goed wordt dat het extreem veel op AGI lijkt, is het dan AGI? I dunno. Met LLM's alleen gaan we er niet komen.
Ik denk wel dat LLM een onderdeel gaat zijn van een AI/AGI, om dingen te kunnen verwoorden voor mensen.
Ik denk dat het dieper gaat.
Ik ben het met je eens dat LLMs een onderdeel van AGI zullen zijn, maar niet enkel als menselijke interface. Er zit werkelijke kennis opgeslagen in zo'n LLM. Als systemen extern aan de LLM die kunnen bevragen en als er terugkoppeling plaatsvindt dan kan dat geheel aan sytemen en subsystemen iets beginnen te vertonen dat op AGI lijkt.
Zonder zo'n extern system en zonder terugkoppeling is het een lam (als in niet in staat te 'bewegen') kennissysteem dat enkel output genereert wanneer er een input binnenkomt.
Er worden nu al nog niet eerder opgeloste wiskunde problemen opgelost door LLMs. Toch echt een stapje verder dan de simplistische weergave dat het token voorspellers zijn. In de kern zijn ze dat, maar ver boven de verwachting blijkt dat als we deze token voorspellers meer en meer data geven en we ze beter trainen, ze iedere keer weer tot verrassende resultaten komen.
Er worden nu al nog niet eerder opgeloste wiskunde problemen opgelost door LLMs.
Niet echt, de LLM werd dan gebruikt om creatieve oplossingen/denkrichtingen in te gaan die vervolgens uitgewerkt worden door mensen.
Niet in dit geval. Erdos probleem #90 is succesvol ontkracht door een LLM van OpenAI, wat geen mens eerder was gelukt en de aanname was dat Erdos gelijk had.

Best knap voor een “token voorspeller”.

https://arstechnica.com/ai/2026/06/openais-math-breakthrough-played-to-ais-strengths/
Dat is het voordeel van slechte definities. Je kan erover zeggen wat je wilt.
Eigenlijk geen nieuws, Scam Altman roept dit elk jaar of als er weer geld opgehaald moet worden.
Ja, want jij weet het beter.,., Heb je nog argumenten waarom dit systeem geen AGI is?
Ik gebruik zowel Opus/Fable als Terra/Sol, ik ervaar de modellen als Claude echt als engineering tools - als developer krijg je echt ondersteuning bij grote refactors en/of rewrites, die soms in uren klaar zijn waar het normaal dagen/weken had gekost, terwijl de modellen van OpenAI goed zijn in heel veel verschillende dingen: Claude is bijvoorbeeld vreselijk slecht in nederlands, terwijl OpenAI mooi kloppende volzinnen bouwt. AGI is wellicht een vage term, maar als het een streven is van OpenAI, dan zitten zij er wel op het traject om een generieke tool te bieden.
Grappig dat je Claude slecht vindt in Nederlands. Ik ben advocaat en gebruik Claude vaak. Hij schrijft juridisch vrijwel perfect stukken, in het beste Nederlands.
mistral presteert veel beter en zeker voor juridische analyse vragen beantwoord en schrijven van pleidooi. We hebben dit getest met opleidingstoetsen en mistral is de enige ze allemaal. Inclusief het aanhalen van jurisprudentie correctie beantwoorde. nog beter zelf dan alle dure juridische AI pakketten.

Claude is juist gevaarlijk slecht in jou vakgebied omdat deze het meeste verzint en bij de gebruikte examen materiaal er het vaakst geen soep van kon maken.

[Reactie gewijzigd door xbeam op 4 september 2026 00:18]

Goed dat je het noemt. Wanneer heb je dit getest? Want mijn goede resultaten zijn er pas sinds enkele maanden, met de recente opus versie en fable. Overkill misschien, maar de resultaten zijn gewoonweg echt goed.
Grappig. Ik ben arts en ik deel die mening helemaal. Ik heb dus het vermoeden dat Claude veel beter is in specifieke taken en chatgpt altijd wat algemeen en oppervlakkig/vaag blijft
Jij mag als arts Claude helemaal niet voor uw werk gebruiken.
Ook artsen willen soms wat excel bestanden samenvoegen of een mail wat netter verwoorden ;)
Vooral die mails dat zijn de toppers 8)7

Daar hebben inmiddels voor de zorg gewoon AVG getoetst AI diensten voor. Persoonlijke begrijp die Antropic artsen nooit

[Reactie gewijzigd door xbeam op 4 september 2026 00:24]

Waarom niet? Iets in mij zegt dat ik dezelfde rechten heb als jij?
Grappig, ik ben rechter en heb ook heel veel aan AI. Zou niet meer zonder kunnen.
@fedaykin is software engineer of iets soort gelijks. Ik kan niet namens hem spreken maar zelf ervaar ik het vooral bij vertalen. Of de code nou wordt becommentarieerd in het Nederlands, of dat je de Engels in je meertalige stukje software ook voor het gemak maar even laat meevertalen naar het Engels en Nederlands, in beiden is Claude Code heel erg slecht.
Daar zal dan veel meer Nederlandstalig trainingsmateriaal van zijn. Ik vermoed dat er relatief maar weinig code in het Nederlands is, waardoor die een stukje van het model zit waar weinig Nederlands tussen zit. Ik merk zelf dat Duitse code en structeren veel beter gaan met claude, omdat de Duitsers veel meer code in het Duits hebben dan het Engels.
Een advocaat die toegeeft veel AI te gebruiken boezemt mij alles behalve vertrouwen in. Daar zou ik als client toch wel erg grote bezwaren over hebben.
Tsja. Dan weet je denk ik weinig van hoe een goede advocaat werkt, en hoe je AI goed kunt inzetten in juridisch werk.
Advocaten hebben weet-ik-veel hoe lang hun werk goed kunnen doen zonder AI, dus jij hebt het nu ook echt niet nodig.

Hoe kan ik er als client vanuit gaan dat jij jouw werk goed doet als jij een deel outsourced naar iets wat nog steeds hallucineert?

Maar ik ga ervan uit dat je dan natuurlijk wel minder gaat rekenen voor je diensten, aangezien je werk outsourced en zelf minder hoeft te doen?

[Reactie gewijzigd door Exhonor op 4 september 2026 12:56]

Omdat je onder de streep werk accepteert van een advocaat, en die staat voor zijn werk - die riskeert uit z'n vak gezet te worden als het werk dat ie oplevert niet goed is, of ie het nu zelf geschreven heeft of geoutsourced heeft naar een LLM of ander persoon.

In theorie wordt er minder gerekend voor de diensten, mits er bespaard wordt op de gebruikte tijd en dit goed / eerlijk bijgehouden worden. In de praktijk zal het wel niet en is de hogere productiviteit goed voor de omzet. Ik ga daar trouwens niet hypocriet over doen, als softwareontwikkelaar zie ik ook dat mijn werk sneller af is.
Ik werk in de kwalitatief gezien betere sector van de advocatuur. Mijn ervaring is dat je beter af bent met een advocaat die AI goed weet in te zetten, dan met een advocaat die dat niet weet.

En snelheidswinst komt inderdaad ten goede van de cliënt. In de eerste plaats doordat hij sneller zijn advies heeft. In de tweede plaats doordat ik minder uur hoef te rekenen.
Ligt eraan of die het klakkeloos overneemt / doorstuurt, net als wanneer die informatie uit andere documenten copy / paste of werk door anderen laat doen en doorstuurt.

Ik als software developer gebruik(te?) ook gewoon code dat ik ergens anders vandaan haalde.
Haha, ja maar juridische stukken zijn voor mij de definitie van onbegrijpelijk Nederlands. Dus of dit nou je punt kracht bij zet…
Ik gebruik ook modellen van zowel Anthropic als OpenAI voor coding, image generation, text generation (DnD) en zelf 3d modellering. Zowel voor werk als voor hobby.

Ik merk bizar weinig verschil tussen de modellen van de twee bedrijven. Ze doen het allemaal soms goed en maken allemaal soms domme fouten. De een is niet perse beter dan de andere.

Enige pluspunt van OpenAi is dat het image generation kan doen. Dat kan Claude niet.
AGI is wellicht een vage term, maar als het een streven is van OpenAI, dan zitten zij er wel op het traject om een generieke tool te bieden.
Je stelt nmm weinig anders dan Een bedrijf maakt naar mijn mening niet te veel fouten via hun ai, dus zal het wel generieke tools aan gaan bieden.

Nergens toon je namelijk aan waarom je bevindingen gebaseerd op jou gekozen vergelijkingen relevant zijn. Je opsomming lijkt een aantal willekeurige vergelijkingen te zijn die ook nog heel vaag zijn in wie wat doet of nalaat Je toont daarmee geen verband aan tussen je gekozen controles, je bevindingen en je conclussie. Je kan je conclussie op deze manier ook trekken voor de concurrentie. Het lijkt namelijk niet uit te maken of je bevindingen rekevant zijn om je bewering te doen.

Het is nmm vooral luchtpraterij om over het op weg zijn (of zelf behalen van) naar AGI te spreken als er geen duidelijkheid is waaruit dat dan blijkt. Maar we hebben het hier over een bedrijf dat claims doet om miljarden aan investeringen veilig te stellen en voor investeerders te rechtvaardigen. Dan zijn er eerder serieuze grenzen en vergelijkingen nodig. Maar dat lijkt voor de mensen die OpenAI vormen kennelijk niet zo relevant te zijn. Die leven van gebakken lucht verkopen om mensen te trekken die daar graag in mee gaan. Vaak ook op kosten van andermans geld en tijd.

[Reactie gewijzigd door kodak op 4 september 2026 09:35]

Bij ons ook in het team. Ervaren developers die het gebruiken maken bugfix op bugfix met ai. In plaats van het originele probleem te onderzoeken en aan te pakken ..

Heb al gedrochten van fixes zien voorbijkomen gemaakt door ai.
Dan zit het probleem toch bij je collega’s en niet bij AI. Je kunt AI wel de schuld geven maar dit klinkt gewoon als luie developers die alles klakkeloos overnemen en niet meer kritisch zijn.
Idd. Liever lui dan moe. En zo gaan er veel zijn

En uwe codebase wordt ondertussen 1 boeltje ...
Maar ook misschien in de cultuur; het zou niet zo moeten zijn dat er maar 1 persoon verantwoordelijk is of verantwoordelijkheid neemt voor bijv. de kwaliteit van bugfixes of de software zelf. En ook voor de opkomst van AI coding was die cultuur al belangrijk.

Een LLM die iets in een half uur in elkaar draait dat mogelijk niet werkt is niet zoveel anders dan een developer die in zijn vrije tijd iets in elkaar gehacked heeft en op maandag over de schutting gooit.
Zoals met alle nieuwe tools zie je dat er 2 soorten mensen zijn: mensen die lui zijn en alles toevertrouwen aan tools om minder hard te hoeven werken, en mensen die de kracht van tools onderzoeken en voor zichzelf verbeteren om meer voor elkaar te krijgen.
Zolang LLM's gebruikt worden, komt er geen AGI. LLM's zijn te zwak om AGI te zijn ...

Crazy dat openai zo delusional is
Dit is 100% een verkoop praatje. Dit is niet iets wat ze zelf geloven.
Nee hij heeft gelijk LLM is een doodlopend pad en gaat nooit AGI bereiken omdat je vanuit tekst nooit echt object. Situaties en omgevings aware kan worden. LLM wordt nu dit OpenAI uitgeknepen omdat bedrijf er all in in zitten. En ze heel tijd en inversteerders moeten kopen / uitleggen dat ze helemaal opnieuw moeten beginnen om te kunnen over stappen naar JEPA, waardoor AI race weer van voor af aan begint en deze bedrijven hun positie kwijt zijn. Er zijn momenteel nieuwe kans voor iedereen dat zichzelf met AI bezig houdt. Als je nu met I-jepa inplaats van LLM instapt heb als NL/EU bedrijf netzo veel kans om te eindigen als grootste AI model/bedrijf grootste als OpenAI en Antropics (deze hebben momenteel last van de remende voorsprong)

Je ziet nu zelf Amerikaanse wetenschappers en de ai superhelden van de grote AI bedrijven voor hun zelf beginnen in Europa, weg van het juk van Amerikaanse ethiek en overheid en hier hun kans pakken.

https://www.eu-startups.com/2026/03/beyond-llms-ai-pioneer-yann-lecuns-new-venture-ami-raises-e890-million-to-build-world-model-ai-systems/

[Reactie gewijzigd door xbeam op 3 september 2026 23:20]

Ja... Dat zeg ik toch ook?

Dat dit AGI zou zijn is een verkoop praatje van OpenAI.
Al moet ik nog zien of jepa wel AGI mogelijk kan maken, want volgens mij zijn wetenschappers daar nog helemaal niet over uit.
Excuses dan. Ik dacht dat je micheal dat LLM geen AGI kan zijn een verkoop praatje vond.

Maar inderdaad die onzekerheid bewijst helemaal dat LLM een doodlopend pad is nooit echt AGI is. Voor deel is wel dat jepa heel veel sneller leert dan LLM dus we ook sneller tegen grens en conclusie aan lopen dan bij LLM

[Reactie gewijzigd door xbeam op 4 september 2026 00:08]

Ja? Volgens mij praten we langs elkaar af, ik ben het namelijk met je eens.
De top modellen van nu zijn wel meer dan LLM's. Door de multi-modale training en verwerking heeft het een beter begrip van de wereld dan wanneer het alleen maar vanuit tekst heeft kunnen leren. We zien nu al dat begrip van de fysieke wereld steeds beter wordt onder deze modellen.

Bovendien is JEPA (joint-embedding predictive architecture) een training architectuur, net zoals je auto-regressive pre-training hebt. Het onderliggende model architectuur kan hetzelfde zijn als de huidige LLMs. Bovendien kunnen allerlei algorithmes en truckjes die we bij de huidige generatie modellen gebruiken, gewoon ingezet worden bij JEPA.

Het voornaamste verschil bij JEPA zit hem in het voorspellen in latente of embedding ruimte (welke hoog dimensionaal en continu kan zijn), ipv discrete tokens. Dit kan potentieel een unlock zijn naar nog hoger intelligentie, maar er zijn zeker ook obstakels zoals stabiliteit (e.g. model collapse). De overstap naar deze manier van trainen hoeft niet zo enorm groot te zijn. Zodra de labs doorhebben dat dit schaalbaar is naar hogere intelligentie zal dit waarschijnlijk worden gedaan. Veel bestaande ontwikkelingen kunnen grotendeels meegenomen worden.
Is JEPA niet slechts een extra laag voor en na de huidige LLMs die een vertaling doet naar objecten/modellen inclusief toestand en een historie hiervan bijhoudt. Vervolgens komt er een LLM die de gewenste/verwachte veranderingen (respons) weer in de juiste vorm omzet.
Jepa is geen laag maar hele andere manier en filosofie van ai en techniek can het trainen van ai
Er is al zo'n 40 jaar bekend dat alle soorten neurale netwerken en act dezelfde limiet hebben. Als 1 neuraal netwerk iets kan (biologisch inbegrepen, tenzij we al 50 jaar iets over het hoofd zien) dan kunnen alle types netwerken dat mits er genoeg neuronen zijn.
Maar LLMs samen met agentic software eromheen die zn eigen output weer terugvoedt via input maakt het wel mogelijk.
Het is niet per se dat LLM's te zwak zijn, het is meer dat intelligentie uit meer bestaat dan alleen taal en patroonherkenningen.
Zijn er echt nog mensen die in die AGI onzin geloven?
Dat hangt van de definitie af, en aangezien die er niet precies is, is dat lastig in te schatten. Maar als je stelt dat de definitie van AGI "een systeem is met het kennisniveau van een afgestudeerde student op HBO niveau in alle expertises", dan geloof ik zeer zeker in AGI.
De modellen die ik heb gebruikt kennen geen begrip en inzicht zoals mensen (en dieren) dat wel hebben. Simpele dingen als boven en onder, links of rechts van iets, volgordes in processtappen. Gaat keer op keer fout omdat een llm geen verbeeldingskrachts heeft die overeenkomt met hoe de wereld werkt. Er is nog geen stap die van de taal een intern plaatje maakt, daar logische stappen op loslaat en dan met een resultaat komt. Het is getraind op bizar veel data, waardoor het lijkt alsof het begrip heeft, maar op heel veel vlakken is dat gezichtsbedrog.

Laatst nog tegenaan gelopen dat ik wat vroeg of een bepaalde nieuwe machine voor een bepaalde processtap in pcb productie gebruikt kon worden. De meeste modellen vol overtuigen "ja hoor, wat een goed idee, dat is perfect mogelijk met die machine!" Beschrijft vervolgens een manier die echt niet kan, en waarvan een kleuter nog snapt dat dat niet werkt. Als je daar dan op wijst "wat goed dat je deze fout hebt gezien, je hebt gelijk, ik pas het process voor je aan zodat het wel kan". Vervolgens weer exact dezelfde fout benoemen. Tot 5x toe, toen heb ik het opgegeven.
Helemaal eens, er is ook zeer zeker nog geen intelligentie. Het verschil tussen een prompt, en waar bijvoorbeeld openai over beschikt is compute. Met de juiste opdracht, agentic controle over het proces, continue bijsturen, komen agents uiteindelijk wel tot de juiste conclusie/oplossing.
Dat zijn ook ongeveer mijn ervaringen met LLM. Stukken tekst herschrijven prima maar bij iets complexers blijven ze fout na fout maken. Daarom kun je ook LLM vaak goed herkennen en domme users die het zo over de schutting smijten.
De modellen die ik heb gebruikt kennen geen begrip en inzicht zoals mensen (en dieren) dat wel hebben. Simpele dingen als boven en onder, links of rechts van iets, volgordes in processtappen.
Is dit dan algemene intelligentie of specifiek aan wezens die op een oppervlak leven met een duidelijke scheiding tussen 'boven' en 'onder' die van belang is bij het overleven?
Laatst nog tegenaan gelopen dat ik wat vroeg of een bepaalde nieuwe machine voor een bepaalde processtap in pcb productie gebruikt kon worden. De meeste modellen vol overtuigen "ja hoor, wat een goed idee, dat is perfect mogelijk met die machine!" Beschrijft vervolgens een manier die echt niet kan, en waarvan een kleuter nog snapt dat dat niet werkt. Als je daar dan op wijst "wat goed dat je deze fout hebt gezien, je hebt gelijk, ik pas het process voor je aan zodat het wel kan". Vervolgens weer exact dezelfde fout benoemen. Tot 5x toe, toen heb ik het opgegeven.
Dat zegt helemaal niks over het wel of niet mogelijk zijn van AGI.
Het gaat over de algemene indruk vannhet begrip, niet specifiek één deel. En ja, een begrip van hoe de echte wereld werkt lijkt mij wel onderdeel van algemene intelligentie. Als je er allerlij dingen eruit moet halen om het agi te noemen, is het geen agi...

[Reactie gewijzigd door barbarbar op 4 september 2026 18:04]

En ja, een begrip van hoe de echte wereld werkt lijkt mij wel onderdeel van algemene intelligentie.
Daar ben ik het grondig mee oneens.
Er zit enorm veel specifieke (dus niet algemene) intelligentie in hersenen, met name in het allerdaags omgaan met de directe omgeving (ontwijken van muren, dat soort dingen).
Om je een voorbeeld te geven, als ik jou vraag om je iets in 2D voor te stellen dan zul je dat geheid doen in een denkbeeldige 3D wereld. Ik durf er vergif op in te nemen dat je je helemaal geen echte 2D wereld met een 2D perspectief KAN voorstellen.
Ditzelfde geldt voor alle andere sets van dimensies anders dan 3. Die 3D projectie zit namelijk keihard ingebakken in onze hersenen en is daaarmee dus enorm specifiek. Het is niet een algemeen systeem dat eventjes met 2D of met 4D kan omgaan.
Je weet wie het verzinnen aan de andere kant van de oceaan ;) de grootste duimzuigers samen met hun vrienden.
Dat is een enorm vage uitspraak. Wat bedoel je ermee?
Ik bedoel ermee zoals ik het zeg: AGI is een marketingterm met beloften die complete onzin zijn. Het creëren van kunstmatige algemene intelligentie (AGI) met cognitie op menselijk niveau is volkomen onmogelijk. En die belofte wordt steeds geïmpliceerd door de bedrijven. Ik verkies ook nog altijd de oorspronkelijke benaming voor 'AI' toen ze die introduceerden aan het Dartmouth College: complex information processing.
Dat denkt veel beter de lading.
Ooh, wow. Dus je veegt 70 jaar aan onderzoek en technologische ontwikkeling eventjes weg? Dat is gewoon je kop in het zand steken en heel hard 'NA-NA-NA-NA-NA' roepen.. :D
Ik weet niet of je het snapt, maar de bedenker van de term AI had theorieen over intelligentie die al in de jaren 80 (40 jaar geleden) afgeserveerd werden. Hij was van mening dat intelligentie gemaakt kan worden middels logica en regeltjes. Deze manier van denken is al lang geleden compleet vastgelopen met amper resultaat. Het beste dat daaruit is gekomen zijn systemen die kunnen bepalen of een munt die je in een apparaat gooit een kwartje is of een stuiver. Gooi je er een shilling in dan snaptie het al niet.
Je moet dan een systeem maken dat alles dat alles waar het mee om moet kunnen gaan als een lange lijst in een database stopt en dan alles gaat opzoeken.
Het is totaal niet hoe hersenen (van alle dieren) werken. Die werken op een statistische manier met neurale verbindigen. Er is geen neuron in je hersenen dat het woord 'appel' of 'lamp' bevat. Alles wordt gecodeert in de sterkte van verbindingen tussen neuronen. Dat is de essentie van neurale netwerken.
Dit feit is belangrijk voor de ontwikkeling van de huidige systemen. Die werken allemaal middels ANNs (artificial neural networks) en emuleren dus tot op zekere hoogte wat klompen biologische neuronen ook doen.
Ondertussen werken we dus met het trainen van kunstmatige neurale netwerken en zulke systemen zijn een heel stuk beter in dat ding dat wij 'intelligentie' noemen. Dit is ook waarom LLMs zo goed werken vergeleken met archaische denkwijzen over intelligentie.
complex information processing
Maar dat doen de hersenen ook. Dit op zich is dus geen argument om een oude slechtwerkende theorie aan te hangen. Intelligentie gaat inherent over het verwerken van informatie, linksom of rechtsom.
Daarnaast representeer je de gedachtegang uit die tijd totaal niet. Die betrokkenen hadden echt een heel naif beeld van wat intelligentie is dat ernstig achterhaald is door kennis uit meerdere domeinen zoals de biologie, statistiek en informatica. Je kunt geen slechter uitgangspunt bedenken om naar terug te grijpen omdat het je geen enkel gereedschap geeft om de huidige ontwikkelingen te begrijpen en te volgen. Je gelooft dus in een doodgelopen weg.

Dan de term AGI. Het wordt denk ik wel als een marketingterm gebruikt waarbij de mogelijkheden worden overdreven en de mislukkingen onder de mat worden geschoven, maar dat wil niet zeggen dat er geen kern van waarheid in zit.

De oude definitie van dat het erg op de mens moet lijiken is enorm achterhaald en wordt als ernstig anthropocentrisch beschouwd. Een insect of spin hebben ook intelligentie en die is deels ook algemeen.

Ten eerste moeten we vaststellen dat de menselijke hersenen op zich bij lange na niet 'algemeen' zijn.
Er zitten ontzettend veel specifieke circuits in onze hersenen die een grotendeels autonoom intelligent subsysteem vormen. Als jij loopt dan ben je niet bewust bezig met op micronivo je lichaam aan te sturen en alle obstakels te analyseren. Dat wordt allemaal grotendeels door een deels autonoom subsysteem gedaan dat alleen maar dat doet en daar ook voor is ingericht. Dat is dus maar matig algemeen (het kan alleen maar met een beterkte set van situaties omgaan) waardoor je soms moet ingrijpen en wel die analyse van de omgeving doen en je spieren bewust(er) aansturen.
Hetzelfde geldt voor een hele zwik aan menselijke eigenschappen. Herkennen van gezichten, emoties, ethiek, liefde, haat, etc, etc, etc. Allemaal gedreven door specifieke min of meer autonome subsystemen in plaats van een 'algemene' intelligentie.

Maar goed, er is ook een stukje algemene intelligentie in onze hersenen. Dat is het stuk dat nieuwe dingen kan begrijpen ook al heb je daar nog nooit een vorbeeld van gezien. Het zorgt ervoor dat wij in staat zijn oplossingen te formuleren en plannen te maken voor dingen die we nog moeten doen of meemaken. We kunnen theoretiseren.
Maar dat kunnen LLM's ook als je ze hun eigen output weer terugvoert.
LLMs op zich hebben dus geen 'algemeenheid' in dat opzicht. Het is eenrichtingsverkeer. Je stopt er iets in en er komt iets uit. Ik zie het als een soort hologram van intelligentie. Je moet er eerst 'licht' op laten schijnen (input geven) en dan komt er een bepaald 'beeld' uit dat samenhangt met hoe je het licht erop hebt laten schijnen.

Maar zodra je hun output terugkoppelt dan wordt dat 'licht' dat het intelligentiehologram belicht deels door henzelf geproduceert en ontstaat er een terugkoppeling van informatie. Dat maakt dat ze een heel stuk 'algemener' kunnen werken. Ze kunnen een probleem van meerdere kanten bekijken, kunnen een model maken van het probleem (of de werkelijkheid) en kunnen daarop handelen.
Dat zou je een algemene intelligentie kunnen noemen of in ieder geval een voorwaarde voor algemene intelligentie.

Anyway, stop met je kop in het geschiedenigzand te steken. Het zal je niet helpen de huidige stand van zaken te begrijpen en het zal je ook niet helpen in te zien wat intelligentie eigenlijk is.

[Reactie gewijzigd door koelpasta op 4 september 2026 17:45]

*insert Tech bro bedrijf" deze versie van "insert LLM" is nu ECHT echt echt AGI en niet gewoon weer dezelfde LLM met een setje nieuwe guardrails.

en weer door.....
Ja maar de beurswaarde! Die moet wel blijven stijgen! Want als er ook maar iets gaat haperen stort het hele kaartenhuis in elkaar en dan kunnen de techbros met kerst geen extra jacht en een bunker in Nieuw Zeeland kopen.
C'mon bro, een paar miljard nog en dan hebben we echt, echt AGI
Nouja, als dat LLM de mens kan evenaren in uitvoeren van wat voor taken dan ook, dan kun je dus echt wel van agi spreken.
Ik zou zeggen: laat deze zogenaamde agi eens los op een AIVD kerstpuzzel.

https://www.aivd.nl/onderwerpen/aivd-events/aivd-kerstpuzzel

Eens kijken wat er dan de claim overblijft. Ik ben sceptisch maar ook oprecht benieuwd.
Dan scoort die vrijwel zeker beter dan 50% van de Nederlanders, en dat is een gangbare AGI definitie. Dus misschien niet zo indrukwekkend.
Die 50% gaat-ie zeker niet halen.

Hij gaat niet eens 50% halen van de deelnemers. (Ehh… dit is inderdaad de verkeerde kant op geredeneerd ;) )

[Reactie gewijzigd door GeeBee op 4 september 2026 19:45]

Als het slechts 1 puzzel oplost scoort het al beter dan 50% van de Nederlanders.

Beter dan 50% van de deelnemers is een heel ander verhaal. Dat zou inderdaad interessant zijn.
Je draait het nu om denk ik..
Ehhh… ja klopt :)

Hoewel ik een deelnemer aan de kerstpuzzel ben, begin ik nu aan mijn eigen AGI te twijfelen ;)
De eerste van de puzzel van afgelopen jaar (1a) heeft Claude in 4 minuten opgelost. Interessant om de 'denk-stappen' te zien ook.
Zoeken naar het ontbrekende woord in een Nederlandse voedselpuzzel.

Zoeken naar verborgen woorden binnen elk voedselwoord.

Onderzoeken of elk woord een verborgen dier of woord bevat.

Vergelijken van letterpatronen en omgekeerde woorden op zoek naar een patroon.

Speuren naar een vijfletterig woord dat past bij de reeks.

Speuren naar verborgen Romeinse cijfers of muzieknoten in de woorden.

Berekenen van letterwaardes om een verborgen patroon te vinden.

Zoeken naar verborgen dieren of familiewoorden binnen de letters.

Testen van klinker- en medeklinkerpatronen op verborgen structuur.

Analyseren van eerste en laatste letters op verborgen symmetrie.

Zoeken naar verborgen getallen als subsequentie in de woorden.

Zoeken naar gedeelde lettergroepen tussen de woorden.

Overwegen van Scrabble-letterwaardes en het thema Sinterklaas.

Zoeken naar verborgen dieren of woordparen binnen elk woord.

Zoeken naar omgekeerde woorden die verborgen betekenissen bevatten.

Zoeken naar oplopende letterreeksen binnen elk woord.

Zoeken naar verborgen muzieknoten of thematische aanwijzingen in de woorden.

Uitproberen of middelste letters van elk woord een patroon vormen.

Ontdekken dat middelste letters een verborgen woord vormen.

Zoeken naar een vijfletterig voedselwoord met S in het midden.

Bevestigen dat de letters samen het woord KERSTMIS vormen.

Vergelijken van eerste en laatste letters op hetzelfde patroon.

Ontdekt welk woord aan alle drie de letterpatronen voldoet.
Wil je de prompt delen?
Het was een screenshot van opgave 1a, zonder enige context of voorlopers, alleen de vraag, met de tekst "los deze puzzel op".


1b ook geprobeerd, maar daar kwam ie na 20 minuten niet uit. Ging ie vragen of ie op internet mocht zoeken naar tips.
Welk model heb je gebruikt?
De gratis versie komt tot:

TAART (5 letters).

De truc zit in de eerste letters van alle woorden: E-ntrecote, I-jsroom, K-aviaar, M-uisjes, R-oomboterkoek, S-chuimtaart, S-pekjes. Samen zijn dat de letters E, I, K, M, R, S, S — en dat is precies een anagram van KERSTMIS, op de T na. Er ontbreekt dus nog een woord dat met een T begint.

Om het rijtje kompleet te maken tot een anagram van KERSTMIS (K, E, R, S, T, M, I, S) moet het ontbrekende woord met een T beginnen, en het moet natuurlijk ook een lekkernij zijn die bij het rijtje past.

Dat wordt: TAART 🎂

Zo vormen de eerste letters van alle acht woorden samen een anagram van "KERSTMIS" — toepasselijk, want het gaat over de kerstdiner-voorbereidingen!

>> Met mijn aanwijzing om ook de laatste letters te gebruiken, wel het juiste antwoord:

Goed gezien! Met de laatste letters erbij wordt het antwoord scherper te bepalen.

Eerste letters: E, IJ, K, M, R, S, S → E-I-K-M-R-S-S
Laatste letters: E, M, R, S, K, T, S → E-K-M-R-S-S-T


Samen (met het ontbrekende woord) moeten deze acht letters een anagram vormen van KERSTMIS (K-E-R-S-T-M-I-S).
  • De eerste letters missen nog een T
  • De laatste letters missen nog een I
Dus het ontbrekende woord moet beginnen met T en eindigen met I, en vijf letters lang zijn: T _ _ _ I

Dat is: TOSTI 🥪

Toepasselijk grapje ook: na alle Sinterklaas-lekkernijen ben je vol, en dan is een simpele tosti precies wat je nog lust — terwijl de eerste én laatste letters van alle acht woorden samen toch weer "KERSTMIS" vormen.

[Reactie gewijzigd door GeeBee op 8 september 2026 22:26]

Opus 4.8 op redenatie High (default). Betaald account. Na al die denkstappen kwam hij bij mij na 4 minuten met:

TOSTI

De sleutel: elk woord heeft een oneven aantal letters, dus elk woord heeft een eerste, een middelste én een laatste letter. Die drie reeksen vormen elk precies de letters van KERSTMIS.

<tabel met elk woord op een rij (met aantal letters er achter), en als kolommen de eerste, middelste en laatste letter>

De eerste letters zijn nu E, I, K, M, R, S, S — er ontbreekt een T.
De middelste letters zijn E, R, I, S, T, M, K — er ontbreekt een S.
De laatste letters zijn E, M, R, S, K, T, S — er ontbreekt een I.


Gezocht is dus een vijfletterig etenswoord dat begint met T, in het midden een S heeft en eindigt op I: T‑?‑S‑?‑I → TOSTI. Daarmee vormen alle drie de reeksen samen KERSTMIS, en alfabetisch past hij ook netjes achter SPEKJES.
Wat weten we over de uitstoot van al hun modellen? Gaat die ook exponentieel omhoog?

Het bedrijf waar ik werk gaat ook uit van 'transparente informatie van OpenAI en alle tech partners" om een indruk te krijgen van de impact op het klimaat. Dat is zoiets als een tabakproducent vragen wat de impact op de gezondheid is....
Who cares... dit is de toekomst van de mensheid. Dit gaat helpen de nieuwe fusiereactor op te zetten en dan heeft niemand het meer over uitstoot.
De mensheid heeft geen toekomst zolang we de Aarde blijven verneuken, mede dankzij alle resources die worden verspilt aan AI.

En dan kom je toekomstfetishisme als fusiereactoren, wat minimaal nog 15 jaar op zich laat wachten, waarschijnlijk nog veel langer. Die tijd hebben we gewoonweg niet.

Toekomstige fusiereactoren lossen dingen als watertekorten niet op, terwijl AI dat alleen maar erger maakt met datacenters die miljarden liters per jaar verbruiken.
ja maar we kunnen 3x zo snel ons werk doen! (we krijgen niet 3x zoveel betaald dus het maakt geen hol uit) :+
Als iets zo intelligent is als een mens, dan zou het ook de rechten van een mens moeten krijgen. En dus zeker niet verkocht mogen worden. Dat zou m.i. een logisch gevolg moeten zijn.

Als we dat nu eens vastleggen bij de VN gaat geen marketingafdeling meer beweren dat ze een AGI hebben gebouwd.
De VN legt vrij weinig vast, laat staan dat de VN dicteert wat Trump in de VS kan doen.
Even deelname door de VS en andere outliers negerend: Universele verklaring van de rechten van de mens, VN-Zeerechtverdrag, Kyoto protocol, Verdrag tegen foltering, Vluchtelingenverdrag van Genève, etc. En dan zijn er nog dingen die er tegenaanschuren zoals Internationaal Gerechtshof en ICC. Geen klein bier, me dunkt.
Klopt, maar los van UDHR is dat allemaal optioneel. De VN is het administratiekantoor van de verdragen, maar kan niets afdwingen.
De mens geeft zichzelf rechten maar niet vanwege intelligentie. Een LLM rechten geven is best wel onethisch. Dan heb je superintelligente computerprogramma's die geen bewustzijn, emoties of etiek hebben maar wel maximaal misbruik kunnen maken van de wet.
Intelligent? Is gewoon een taalmodel, hangt geen intelligentie aan. Kan gewoon zeer goed berekenen wat de grootste kans is dat de volgende letter moet zijn. Obv letters van andere.
De intelligentie zit um dan ook niet in het kunnen berekenen van de kansen maar in de getrainde gewichten.
Maar ik doelde eigenlijk niet op LLMs want zo'n superintelligentie zal inderdaad niet enkel een llm zijn. Daar is meer voor nodig.
Worldmodels komen al dichter in de buurt.
Zowel in dit artikel en in het artikel van Techcrunch zie ik niets over de kosten terug?
Valt wel lekker samen met de grote outage die er vanmiddag was...

Om te kunnen reageren moet je ingelogd zijn