OpenAI brengt GPT-6 Astra uit voor betalende klanten, ook in Nederland en België

OpenAI heeft twee dagen na de release van GPT-6 Astra het model beschikbaar gemaakt voor betalende abonnees. Eerst was het alleen te gebruiken voor zakelijke klanten en daarop kwam veel kritiek. GPT-6 Astra is ook beschikbaar in Nederland en België.

GPT-6 Astra werkt nu voor onder meer betalende Pro- en Plus-abonnees, zegt directeur Sam Altman. Ook zakelijke abonnees die niet in het Daybreak-programma vallen, kunnen met het model aan de slag, aldus het bedrijf.

OpenAI bracht GPT-6 donderdag uit, maar maakte het niet beschikbaar voor reguliere betalende klanten. Altman bood al excuses aan, nadat vooral betalende klanten met een Pro-abonnement zich lieten horen. Pro-abonnementen kosten 103 euro per maand en bieden vaak bij de release toegang tot de nieuwste modellen en functies.

Stap vooruit

De modelbouwer noemt GPT-6 Astra een grote stap vooruit. Het model moet aanzienlijk beter presteren en meer taken kunnen uitvoeren dan OpenAI's huidige frontiermodel, GPT-5.6 Sol. Het bedrijf benadrukt daarbij vooral het gebruik van AI-agents.

Astra kan computers en webbrowsers veel beter bedienen dan zijn voorgangers, claimt het bedrijf tegenover journalisten. Het model kan 'sneller afspraken boeken, vacatures zoeken en appartementen vinden dan de meeste mensen', beweert de AI-maker.

Het model is volgens OpenAI ook in staat om zelfstandig werkende websites te bouwen en 'opgepoetste' documenten, spreadsheets en presentaties te maken.
GPT-6 Astra
GPT-6 Astra

Door Arnoud Wokke

Redacteur Tweakers

05-09-2026 • 10:18

69

Reacties (69)

Sorteer op:

Weergave:

Bizar hoe goed dit werkt. Als test River Raid (C64) laten nabouwen.

Aanpak:
  • Astra gevoerd met de website die het spel beschrijft + wat screenshots
  • Gevraagd om daaruit een prompt voor Codex te schrijven
  • Expliciete eis: alles zelf genereren, dus geen gekopieerde sprites of assets
Codex daarmee aan het werk gezet. Na ca. 15 minuten en 2 iteraties lag er een complete Python-versie: sprites, geluid, handleiding, QA-tests. Werkt, speelt lekker, en lijkt verdacht veel op het origineel, waar de oorspronkelijke maker destijds vermoedelijk iets langer dan een kwartier over deed.

Enige minpunt: 85% van mijn 5-uurslimiet verbrand in die 15 minuten.

[Reactie gewijzigd door schroevendraaier480 op 5 september 2026 15:51]

Vet, maar river raid is nou niet een bepaald complexe game, hier doet een mens hetzelfde in een uur namelijk:

YouTube: ASMR Programming - River Raid in C - No talking

Dus 4x zo snel als een mens, maar op basis van de token consumptie vermoed ik dat de mens in dit geval wel significant meer dan 4x energie zuiniger was :p
En je kan dan lekker koekjes eten om de energie weer aan te vullen ;)

Maar het is maar net hoeveel je al van de programmeeromgeving kent. Ik heb een Python tooltje gemaakt en ik heb niet eens naar de code gekeken tot nu toe, werkt uitstekend. Als je het wilt uitbrengen wordt het natuurlijk een ander verhaal, maar dit is letterlijk "in house", mijn huis wel te verstaan. Die C programmeur was vast erg goed thuis in de taal / omgeving.

Ik ben ook met een lib en uitbreidbare tool bezig (O/S) en daar wordt er qua code natuurlijk meer gevraagd van de tool, en dan zie je toch af en toe design-fouten optreden, te kort aan documentatie enzovoort.

[Reactie gewijzigd door uiltje op 5 september 2026 19:59]

Net uigetest in codex met een Plus abonnement, 5-uur limiet zit er na 10 minuten volledig door :D (GPT6-Astra medium), en dat was dan enkel maar voor het schrijven van een plan. Het zal zonder twijfel prima zijn voor complexe uitdagingen, maar ik heb de indruk dat de consumptie limieten steeds strenger worden dichtgeschroeft. Het verschil in consumptie tussen de 4 modellen die OpenAI nu aanbiedt wordt wel erg groot. Met het Luna model geraak je bv. erg ver terwijl dat model best prima prestaties met zich meebrengt.
Dat is ook wel een beetje hoe de vooruitgang met deze modellen werkt. Hoe groter hoe beter, hoe meer nadenken hoe beter. Er zijn natuurlijk wel wat innovaties die de modellen efficiënter maken, maar een groot deel is nog steeds te wijden aan meer processing. Kijk bijvoorbeeld naar agents, die kunnen een hoop maar gebruiken daar ook steeds meer tokens voor.

De uitdaging met deze tools ligt hem dus vooral in hoe je consistent meer waarde kan creëren vergeleken met deze zelfde taak uit te voeren via normale arbeiders. Dat is niet altijd even makkelijk, als ik al naar programmeren kijk dan geven de modellen regelmatig output dat de prullenbak in kan. Die afweging zal ook bij dit model weer spelen. Duurder model dus de output moet vaker echt wat opleveren.
Het zal ook wel deels prijsstrategie zijn. Er is amper te controleren of je tokens nou echt zo goed en efficient toegepast worden en ze moeten een keer ook goed geld gaan verdienen.

Wel gek dat ze het zo snel publiekelijk releasen. Dan houdt hun (marketing)verhaal "het is zo'n goed model, we geven het alleen aan securitybedrijven" toch ook geen stand.
Niet alleen dat, je gebruikte tokens of verloren tijd worden door LLM niet geretourneerd bij gemaakte fouten.
ik heb een keer een melding gemaakt bij openai nadat codex met 5.6 zelf toegaf dat hij in een loop terecht was gekomen en daardoor al mijn tokens had verbrand. Kreeg netjes een reset van openai.
Ze proberen wanhopig om échte cashflow te genereren, want ze weten allemaal dat heel het speelkwartiertje bijna gedaan is. De gigantische investeringen moeten nu vervangen worden door echte inkomsten. Als ze dan nog eens zelf voor hun dure onzichtbare "fouten" moeten gaan opdraaien ipv hun klanten ervoor te factureren zal de kostprijs waarschijnlijk nog eens verdubbelen.

Iedereen die geloofde dat die dingen zomaar (bijna) gratis draaien is heel naïef geweest. Tijdens de "opleiding" of het bouwen van de modellen wordt al die tijd als part of the investment gezien, maar wat het boeltje écht kost, daar zouden velen nog van schrikken, de megacorps hopen dat je tegen die tijd er zo hard aan gewend of invested in bent dat je niet meer zonder kan en dan zullen er zware beslissingen moeten gemaakt worden.
De gigantische investeringen zijn met eigen geld (op basis van gigantische winsten) geinvesteerd in bedrijven als OpenAI. Niemand (zeker niet de aandeelhouders / groot-investeerders) gaan uit van 'gratis' investeringen. Dus het moet natuurlijk wel geld gaan opleveren. Het belangrijkste is nu om zoveel mogelijk concurrentie over te nemen, dan wel uit te schakelen. Er zullen de komende jaren heel veel overnames gaan plaatsvinden.
Overnames? Met welk geld? Die toko's hebben nu al elk kwartaal een miljardeninjectie nodig, puur om het licht aan te houden. En zelfs als ze het geld zouden hebben, wat kopen ze dan? Een andere tekstvoorspeller die precies hetzelfde kan.
NVidia heeft huggingface overgenomen. Nog niet zo lang geleden heeft Antropic Cursor AI opgekocht. AI heeft inmiddels een groot deel van de kinderziektes verholpen en gaat nu naar de tienerjaren waarbij kannibalisme nodig. Survival of the fittest.

Anthropic en OpenAI zullen grotendeels in elk geval de westerse markt gaan bepalen vergelijkbaar met hoe Netscape en Internet Explorer dat ooit deden. Er waren ook andere browsers (zowel commercieel als open source), maar die nooit meer dan 1% marktaandeel gekregen en NS en MSIE hadden gezamelijk al 95% van de markt in handen.

Het Franse Mistral is technisch gezien een concurrent, maar heeft minder dan 1% marktaandeel. De Amerikanen zijn niet bang voor Europese alternatieven wat Europa is voor Globale investeerders minder interessant geworden. Europa belast en reguleert alles helemaal kapot. De grootste concurrenten komen vooral uit China en dan met name uit de Alibaba stal (DeepSeek, GLM, etc) en Kimi. Zeer goede AI modellen, zijn iets minder krachtig dan de Amerikaanse giganten, maar zonder Fable hadden vele developers nu nog in Opus gewerkt en GLM 5.3 is wel weer een stuk krachtiger dan Opus 5. Maar vergeet niet dat je dan ook zeer krachtige hardware nodig hebt en zeker op dit moment is hardware extreem duur. Ik heb twee Claude Max20, twee OpenAI Pro20 subs met daarnaast nog een ChatLLM Pro sub met 50 euro extra credits. Dat kost mijn werkgever zo'n 850 euro per maand. Dat is 10K per jaar, maar dan heb je wel altijd toegang tot de laatste modellen en hardware.

Eigen AI hardware is alleen interessant als je alles in-house wilt houden. Performance en prijs van de externe partijen is vele malen beter. Mijn werkgever betaald zonder problemen die 10.000 euro bovenop mijn salaris als dat betekend dat mijn output 2 tot 3 keer zo hoog is, want dat betekend dat hij twee tot drie keer zoveel kan facturen.
Het gaat niet om fittest in het overleven, maar om degene met het meeste geld, de goorste trucs. Alles lijkt zo'n beetje geoorloofd te zijn. Bij gebrek aan ethiek, zijn er vermoedelijk nauwelijks grenzen die men zou willen respecteren. Geld, dat is het enige wat speelt. En dan is het wel raar dat we dan zoveel 'goeds' van zoiets verwachten. Op dit moment is het puur machtsstrijd. En de consument consumeert. Want niet meegaan 'kan niet'.

Aan de andere kant: wat/waar zijn IE en Netscape nog. Het kan verkeren (zei Bredero al).
Er vinden talloze overnames plaats in AI-land, legio voorbeelden. Met (NVidia) eigen geld.
Enterprise is niet security
wat je ziet is dat de Chinese modellen over het algemeen vooral focussen op betaalbaarheid, niet per se omdat ze daarop focussen, maar ze hebben zelf niet genoeg chips om mee te doen met de grote jongens dus focussen ze op efficientie.

Die efficientie is echt bizar, de technieken zijn cutting edge en de kosten zijn vaak 10x lager voor 90% van de performance, het is eigenlijk niet meer logisch om de laatste westerse modellen te gebruiken behalve als je graag op het randje zit.
De laatste tien procent extra is altijd veel duurder geweest. De 10% snellere auto, videokaart etc, zuiverder chemische samenstelling etc. Dat is gewoon inherent aan het uitpersen van de laatste procenten.
Astra blinkt juist uit dat juist minder hoef na te denken is volgens hun papers token efficiënt. Ook wordt trainen van modellen steeds sneller en goedkoper. Dus ik denk vooral dat ze premium vragen als soort enshitfication en voorbeeld volgen van Claude wat ook zo extreem was. Winst maximalisatie najagen van plaats user experience schappelijk houden. Tegenwoordig staat dat laatste helaas op de laatste rij bij alles wat To big to fail is. Want de Wet van Moore bij A.I is dat elk jaar ai dubbel zo snel te trainen is voor zelfde intelligentie. Dan heb je ook nog alle software/engine technieken die hard door ontwikkelen. Dus a.i gaat elke 2 jaar onderhand quadruple in evolutie als niet meer is op dit moment Hoewel dat lastig te peilen is vergeleken een transistor want die tel je. Maarjah de hele chain verbeterd van a.i Meer parameters, effiecenter per parameter, software denk aan interference,harness,hardware etc, etc.

[Reactie gewijzigd door bigkillerstorm op 5 september 2026 12:56]

Ik heb de paper niet gelezen. Dus misschien zit ik er naast. Maar is het op dit moment niet ook gewoon een balans waarbij een groter model minder hoeft na te denken of een kleiner model met meer nadenken. Als je het ene inruilt voor het ander is het niet perse een verbetering onder de streep. Wel kan er mee tweaken, meer geheugen of langer nadenken. Maar de kostprijs gaat hoe dan ook omhoog zodra je een beter eindresultaat wil bereiken.
Maar de kostprijs gaat hoe dan ook omhoog zodra je een beter eindresultaat wil bereiken.
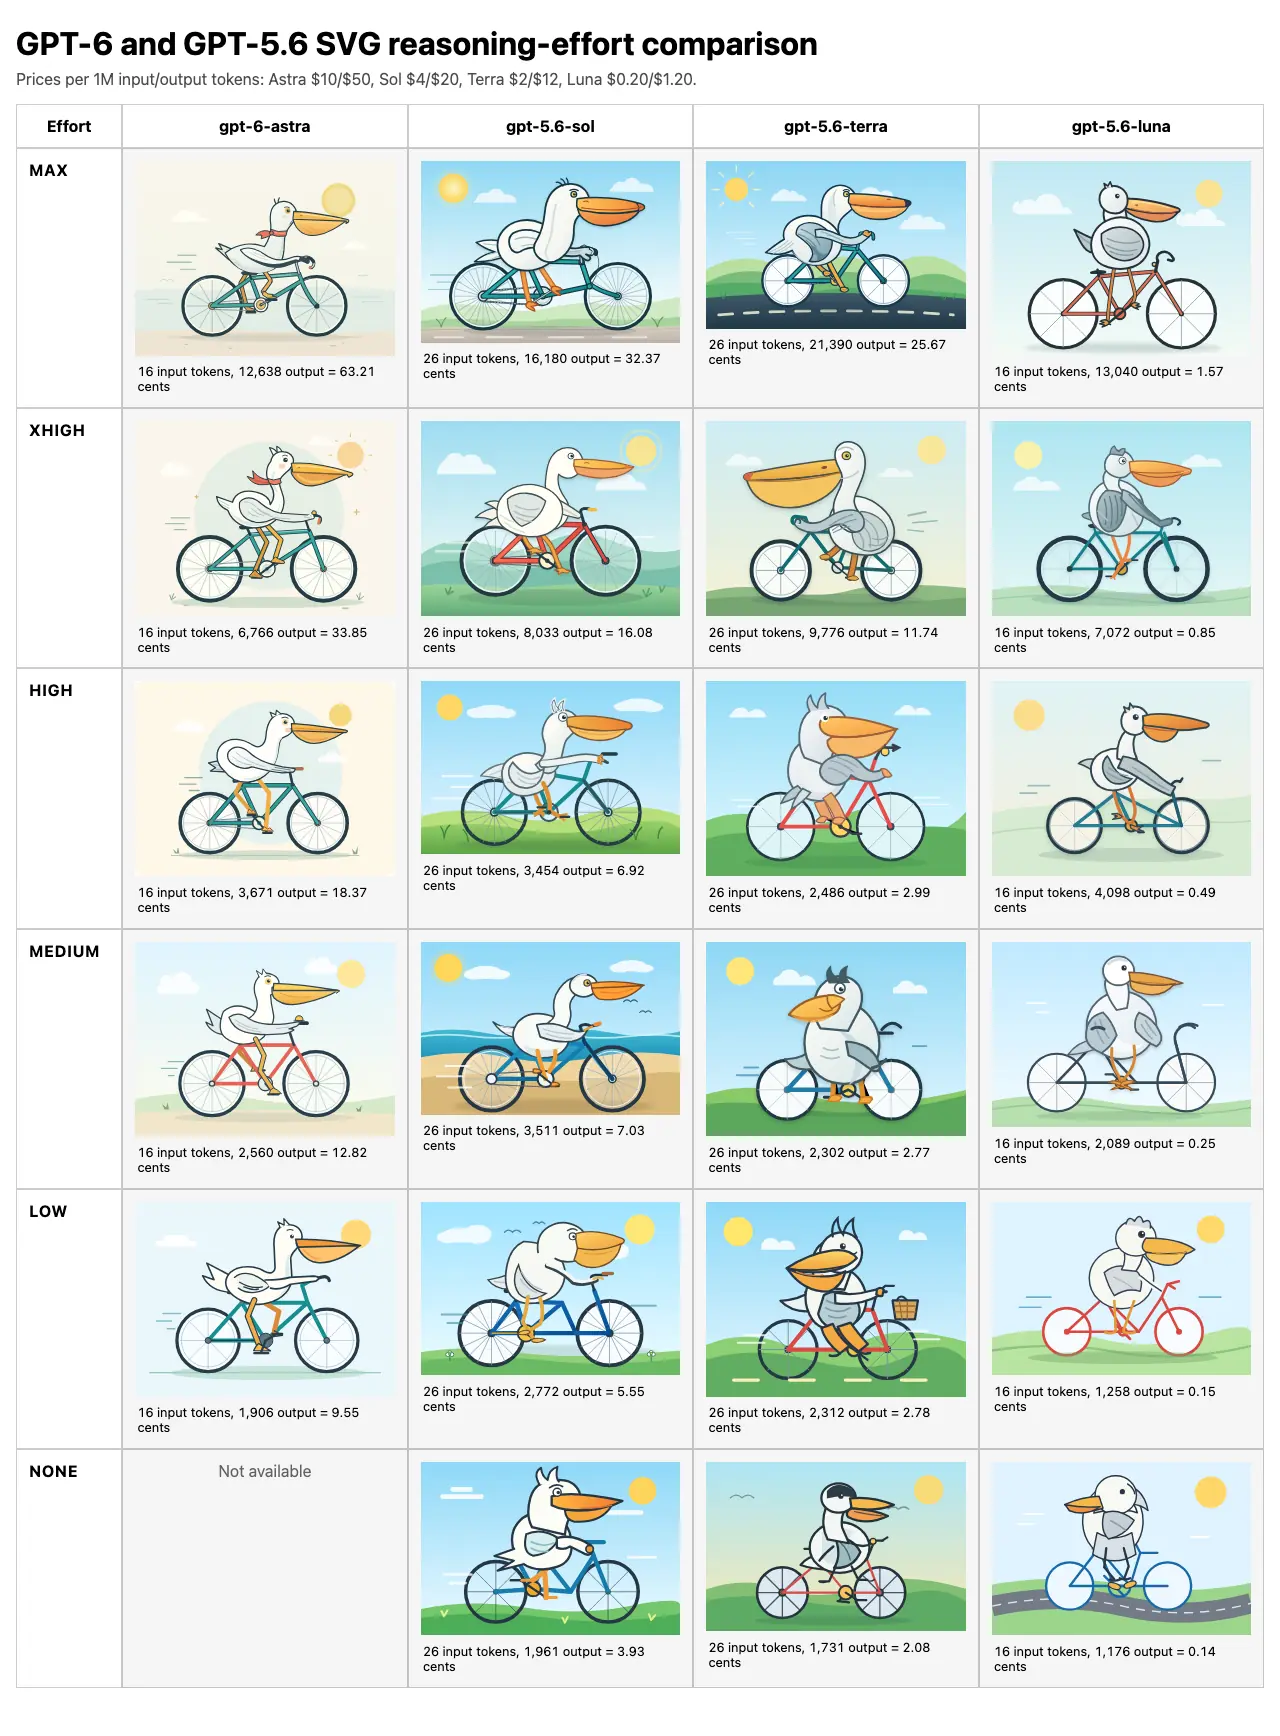
Niet altijd. Een voorbeeldje.

Het resultaat van astra low (0.095 USD) is hier een stuk beter dan het resultaat van terra max (0.256 USD), en in mijn ogen zelfs beter dan sol max (0.323 USD).

Het beste resultaat is hier het goedkoopst.
Hoe verhouden pelikanen en fietsen zich tot de kwaliteit van de gegenereerde slop? Dit is toch compleet willekeurig?
Dat snap ik ook wel gezien de enorme kosten die zo'n frontier-model meebrengt. Een ouder model zal met minder power tevreden zijn, en daardoor kunnen ze ruimere limieten toekennen voor hetzelfde abo. Wel interessant dat dat model dus voor een Plusser maar 10 minuten werkt per 5 uur, da's luier dan een hoop medewerkers.
In mijn opinie zijn de verbeteringen van AI al een jaartje niet heel relevant meer voor de gemiddelde consument meer, in ieder geval niet met de huidige prijs ervan. Hoeveel heeft Jan modaal aan een model dat beter kan programmeren? qua kansen is het leuk als jan modaal een echt plan heeft, maar meeste mensen willen gewoon dat AI hun documenten samenvat om dan door te emailen, en dat kunnen LLMs al een tijdje meer dan goed genoeg.
Is het meestal daarom niet aangeraden dat het plan door een goedkoper model wordt gedaan en de meer complexe taken door de nieuwere/duurdere modellen?
Wat ik begreep was dat je zo'n duur model een zwerm goedkopere modellen aan zou moeten willen laten sturen, zodat je alleen tokens verbrand aan het echte denkwerk.
Bestaan er nog 5-uurslimieten? Ik ken in Codex al een hele tijd enkel weeklimieten.

En op dit ogenblik heb ik zelfs een gewone weeklimiet en een reserve weeklimiet. Geen idee waarom, maar ik kan nu 2x zoveel verbranden als voorheen.

Zelf GPT6-Astra maar nog niet uitgeprobeerd. Sol high doet het voorlopig ook!
5-uurs limieten zitten alleen in het plus abo, niet in de pro abo's.
Ik krijg op mn zakelijke Pro account zo vaak spontane resets, snap er weinig van, maar ik vind het prima.

Daarnaast krijg ik ook veel van die resets die je zelf kunt toepassen. En die vullen soms zichzelf weer aan terwijl ik er net 1 toegepast heb. Raar, maar ik klaag niet want ik zit net in een inmiddels 18uur durende refactor. Koekkoek
Vandaag weer een 'banked reset' die je binnen een maand mag gebruiken:
Because we are beyond happy to have Astra rolled out today ahead of schedule and you have been super patient with us (not really, but it’s ok!)… we will do the full banked reset today too for all Plus, Pro and Business users. Lands end of day.
Is de laatste paar maanden inderdaad vaker gebeurd. Vanuit OpenAI wordt dit gebracht als het vieren dat er een bepaalde active user limit is bereikt, bijv op 31-08 :
What I wanted to say yesterday is that we hit 25M active users and to celebrate we have now reset usage for all paid subscriptions for ChatGPT Work and Codex.
En in github copilot heb je dus een maandlimiet. Kan je in een paar uur doorheen branden en dan is het tot volgende maand op :+
De 5 uurs limieten waren een tijdje terug verwijderd, maar komen nu weer langzaam terug. In ieder geval voor het plus abo zijn ze sinds vorige week weer terug. Bij de pro abo's komt dit_voorlopig_ nog even niet terug:
We are for the upcoming months keeping the 5h limit not enabled for Pro $100 and Pro $200 subscriptions.
(https://x.com/thsottiaux/status/2092058556707344708)
Aha. Nog niks van gemerkt. Ik heb nog steeds een week limiet. En die heb ik er vandaag helemaal doorheen gejaagd ;)

Helaas werkte de gpt reserve niet. Een bug heb ik begrepen. Anders had ik nog een 100% kunnen aanspreken.
En anders zijn die 5 uurs limieten sowieso 5x zo hoog. Nou kan je daar natuurlijk ook snel doorheen zijn bij complexe opdrachten. Momenteel is het wel een doolhof welk model & redeneer niveau je wilt gebruiken. Maar goed, die vraag kan je prima stellen aan Sol-fast :P
Het zou jammer zijn als er te strenge limieten komen. Het was voor mij de reden om mijn abonnement voor Claude meteen op te zeggen na mijn eerste maand, omdat ik meteen tegen limieten aanliep toen ik enkele wetenschappelijke pdf’s vroeg te analyseren.
Ik had gisteren precies hetzelfde. Astra is compleet onwerkbaar met een Plus-abonnement
Inderdaad, hier hetzelfde. Onbruikbaar. En dan heb ik 'm ook nog op licht geprobeerd. Voor een kleinere coding taak ingezet, en bijna al m'n tokens voor 5 uur erdoor. En dan werden er ook nog zaken over het hoofd gezien, wat weer gefixt moest worden. Dat heb ik met 5.6 Sol (gemiddeld) gedaan, die bevalt mij tot nu toe het beste.

Als we een paar iteraties verder zijn, en de efficiëntie is beter, dan wordt het misschien bruikbaar. Issue is nu (wat het 5.6 model aangaf) dat (net als wij mensen ook wel eens doen) het model aan het overdenken is, van een mug een olifant maakt, terwijl dit helemaal niet nodig is. En dat verbrand binnen een mum van tijd al je tokens.
Heel andere ervaring hier. M’n app die ik in swift ui heb gebouwd om laten zetten naar een native Android versie. Ben impressed war deze versie voor mvp oplevert binnen 2uur.
Vooral omdat ik nu al 5x zijn antwoorden moet bevestigen gaat het snel.
Ik heb ook steeds meer het idee dat de zekerheid van een goed antwoord steeds meer geforceerd wordt om maar sneller door de credits heen te zijn en je een hoger abonnement aan te smeren.
En dan durven ze nog te vragen of ik credits cadeau wil geven...
Dat is veel voor plus abo als ik eerlijk ben. Dat je elke 5 uur er 10min flinke prompts op kan gooien voor dit model is belachelijk goeie deal.

Astra is geen lachertje. Het heeft zojuist mijn hele codebase echt 5 levels verhoogd en deed het allemaal in 1keer. Absoluut top model tot nu toe. Ik heb dan wel een 20x abo van 200 euro maar het is elke cent waard voor mijn use case. Dat je met een abo van 5 euro ook flink gebruik kan maken van Astra is echt een goeie deal. Ik had als open AI zeker niet Astra aan de plus gebruikers gegeven. Antrophic geeft Fable niet aan de goedkopere abonnementen en Astra is veel beter
Na 23 Minuten werk Astra / Light in codex op een Plus abo aan een bestaande browser extensie/backend, tegoed volledig verbruikt, mag dinsdag weer verder. Dat is dus zinloos. Hoe goed dat model ook is.

[Reactie gewijzigd door masterfragger op 6 september 2026 10:11]

GPT-6 Astra werkt nu voor onder meer betalende Pro- en Plus-abonnees, zegt directeur Sam Altman
Volgens mij zegt hij juist dat het voor Pro gebruikers nu direct beschikbaar is, maar dat Plus gebruikers later aan de beurt zijn
In de gelinkte tweet staat:
Now out to all Plus and Business users.

Happy building!
De quote waarin hij noemde dat het voor Plus nog moet komen ("We will start rollout to Plus and Business users next.") was van gister. :)
Handig, op mijn telefoon staat er precies een popup over de nieuwe tweet, die ik niet weg krijg. Op m'n laptop zie ik het inderdaad wel.

Maar als Plus gebruiker zie ik Astra nog niet beschikbaar in de iPhone app en de web app. Ook niet bij 'Work'.

[Reactie gewijzigd door Cybje op 5 september 2026 10:53]

Ik heb Plus en in de ChatGPT desktop app heb ik Astra beschikbaar.
Ik heb Plus en kan er nu mee werken (y)
Ik ben al een tijdje een game aan het bouwen en sinds vannochtend bouw ik verder met Astra medium in Codex. Ik was al verbijsterd over de kwaliteit en ik heb direct een moeilijke taak gegeven en eerst een plan laten maken... Ja, in half uur tijd zijn 50% van mijn dagelijkse budget er doorheen, maar dit had me denk ik een maand werk gekost als ik dit zelf had gedaan. En zo secuur!

Het is echt bizar dat als je kennis hebt van softwareontwikkeling en saas infrastructuur dat je gewoon een applicatie kunt bouwen in dagen in plaats van maanden. Astra en hiervoor Sol zijn al zo belachelijk goed. "Men" heeft echt geen idee hoe krachtig dit is. We gaan echt een gekke paar jaar tegemoet, en dat is zeker niet allemaal positief!
Zelf laat ik AI niets meer schrijven, hoewel ik zelf soms wel stukjes code door AI laat beoordelen. Schrijven door AI ben ik volledig mee gestopt (dat was wel moeilijk), want ik merkte dat ik daardoor heel erg lui werd, en de kwaliteit, betrek en verstand van mijn projecten hard achteruit ging. Ook het gevoel van trots verdween volledig, want ik had het niet gemaakt, maar AI.

In hoeverre ervaar jij dit?

[Reactie gewijzigd door Memori op 5 september 2026 20:47]

Denk dat perspectief wel wat uit maakt, je redeneert vanuit het perspectief code klopper, en dat herken in ik. Het kan heel goed zijn dat die manier van software maken 'verloren' gaat en dat mensen dat daar weemoed om voelen. Ik denk/hoop dat er een markt overblijft voor de ambacht waarin de handtekening van de ambachtsman zijn selling point wordt.

Anderzijds merk ik in een wereld waar altijd alles te laat opgeleverd word, we eenheidsworst werden met een verzameling cots producten . Kennis overdracht beperkt door absorptie capaciteit en leervermogen. Tijdsgedwongen kwaliteit beperkt door documentatie en/of testbase achterwege laten...

...het een genot is om met "leger" aan agents een platformarchitectuur neer te zetten dat netjes volgens het boekje, volledig rekening houd met de legacy codebase , ongedocumenteerde nuances ee netjes uithaalt. Context die bewaard blijft en constant beschikbaar is voor vragen hoe dingen werken, kleine of grote aanpassingen last minute na dato of jaren later, zonder morren doorgevoerd worden.


Mijn algehele advies voor de dev die zijn werk ziet verdwijnen, probeer een/of meerdere laagjes hoger te denken over software, dus minder over de regels code, meer over hoe zetten we die software in, just hoe kunnen we de user/ colleague experience verbeteren. Raken gevoel kwijt , ja indd, maar hoe kunnen we dat compenseren (ik zit atm op: de volledige testsuite uitbouwen, waar ik overigen als dev zinloos vond, want ja ik had zoveel gevoel ik wist wel dat het zou werken)
Ik ben zelf python/PHP programmeur maar ik ben met de komst van AI echt gigantisch lui geworden. Ik heb gigantische teksten geschreven voor MD bestanden, sinds die tijd kijk ik alleen nog maar naar de output en druk ik om merge, ik schrijf zelf helemaal niks meer.

En ja eens er zit totaal geen voldoening en trots in. Ik ben me inmiddels al aan het omscholen naar elektricien ik zie hier geen toekomst meer in.
Ik merk dat een hybride beter is. Dat ik zelf de architectuur bepaal en dat de AI vervolgens de implementatiedetails invult. Dan kun je ook beter reviewen, want als de AI dan dingen gaat aanpassen die je niet verwacht zie je het meteen. Soms is het troep, soms heeft ie gewoon een goed punt. En soms kom je samen tot een betere oplossing.

Maar die luiheid, snel even features rammen, dat kan ook goed zijn. Snelheid wint vaak, ook al maak je dan fouten.

Ik ken iemand die zit gewoon een game engine te vibe coden. Heeft totaal geen benul wat hij aan het doen is en probeert met Claude de nieuwe Unreal Engine te maken. Toch heeft hij al 50 klanten die straks geld willen neertellen om die troep te gaan gebruiken :+
Fake it til you make it, I guess.

[Reactie gewijzigd door Wolfos op 7 september 2026 09:50]

Ik heb altijd software geschreven uit noodzaak omdat ik dingen wilden die er nog niet waren of pasten. Later ben ik specs gaan schrijven voor software en was ik meer een product owner of product manager. Dus voor mij is het enorm leuk om weer alles te maken en te zien dat ik ineens superkrachten heb. Wat ik wel doe is dat ik na iedere grotere verandering vraag naar de essentiele stukken uit de code en deze review en ook architectuur vragen stel en wil begrijpen. Wat ik ook leuk vind is dat ik nog meer hands-on ervaring krijg met Vercel / Supabase/Hertzner/Cloudflare (AWS/GCP/Azure ben ik al erg bekend mee).

Ik ervaar eerlijk gezeg niet het gebrek aan trots. Uiteindelijk gaat het om wat je met je geest maakt en AI voert het uit. Als mensen het gebruiken en positief zijn is het doel gehaald. Ik vind het juist geweldig dat de iteratie niet weken en maanden is, maar dagen. Ik denk dat als je juist AI weer vraagt om je mee te nemen in de essentie van dingen je best betrokken blijft.

[Reactie gewijzigd door Henrikop op 8 september 2026 10:55]

Ik werk al geruime tijd met Claude Code aan onze SaaS producten en daar was het al hard gegaan (zeker met de introductie van Fable).

Sinds gisterenavond heb ik toegang tot GPT6 en alhoewel deze wel wat beter is dan Fable, het is geen monumentale stap. Het voelt iteratief.

Maar inderdaad, als je het vergelijkt met modellen van 2 jaar geleden is het ongelofelijk. Van fancy autocomplete naar volledige software dev.
Komt Astra alleen in work codex en niet in reguliere chat?
Zo ver ik zie niet in chat in de browser, wel in Work in de browser en ook in ChatGPT zelf in de desktop app (in ieder geval MacOS).
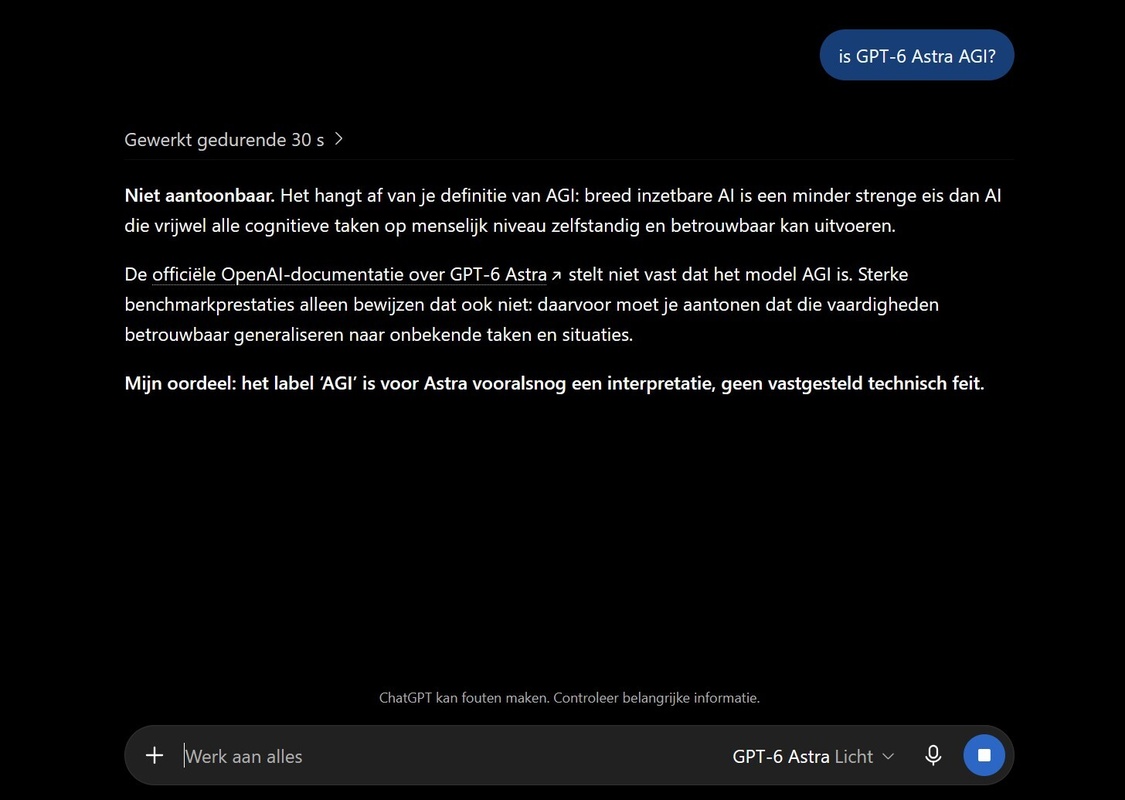
Dat is echt een koopje voor AGI zou ik zeggen
Ik heb er sinds gisteravond al mee zitten spelen. Het is zeker een verbetering ten opzichte van GPT 5.6, maar het is ECHT geen AGI.

Het is een heel goed coding model, kan goed meekomen met Fable 5.1 (op sommige punten misschien er wel overheen), maar het snapt niet altijd logische gevolgen/stappen.

Ik heb zelf al een hele tijd een klein spelletje waarin je rond kan lopen en kan rijden, puur gebouwd met AI modellen. Alles wordt dynamisch gegenereerd (de kaart, gebouwen, de straten, etc...). Ik heb Astra gevraagd om de performance te verbeteren, de model-creep door het continu te veranderen van model om verbeteringen door te voeren zorgde voor veel overhead.

Astra haalde simpelweg de grond weg, dus de straten, interieurs, piazzas, etc...
Nou is dat TECHNISCH gezien wel een performance verbetering, maar het is natuurlijk geen verbetering.

Dus nee, AGI is het zeker niet.
Als je tegenwoordig nog OpenAI gelooft (of elk ander bedrijf) dat het volgende model AGI is, heb ik een brug te koop staan
Ik ben er al mee aan de slag - we hebben al ruim 1,5 jaar een Team license; ben o.b.v. een enkele prompt en wat documentatie een pitch aan het samenstellen voor een vervolgtraject.

Vanuit mijn rol helpt het enorm om voorstellen netjes en inhoudelijk volgens strikte model projectplannen uit te werken, ideaal!

Collega's die meer in de development hoek zitten gebruiken CODEX vooral en zijn daar ook erg over te spreken.

Update - terwijl ik deze comment type komt de output er natuurlijk al uit haha Het is iig precies wat het moest worden: o.b.v. een half ingesproken transcript - wat meeting notes en een powerpoint komt er hele sterke pitch uit. Ik denk dat met model 5.6 sol dit ook wel had gedaan overigens.. heb na het weekend nog wel meer zaken om met het nieuwe model te gaan testen!
Vergeet het maar om Astra te gebruiken met een plus-abonnement, want je 5-uurslimiet is er letterlijk in 10 minuten doorheen. Dus je kun het model mogelijk 1 simpele prompt sturen per 5 uur, en dat betekent dus dat je het zo’n 1 simpele vraag per dag kan sturen omdat je anders veel sneller door je weeklimiet heen bent.
Ook met pro is het behoorlijk gelimiteerd, maar dat is wel vaker zo met het nieuwste model. Als deze ook nog eens meer gebruikt per opdracht dan is het logisch dat ze niet in een keer van 0 naar 100 gaan.
Ik ben super geinteresseerd hierin, maar ben ook nogal anti-big cloud diensten aan het worden. Kan me voorstellen dat er (nog) geen lokale modellen zijn die hieraan kunnen tippen. Maar geen idee. Is er niet ergens een plek waar lokale modellen overzichtelijk en toegankelijk worden gemaakt voor de leken?

Om te kunnen reageren moet je ingelogd zijn