OpenAI claimt wiskundig Millenniumprijsprobleem binnen 88 uur te hebben opgelost

OpenAI claimt een van de zeven Millenniumprijsproblemen te hebben opgelost met een intern AI-model. Het gaat om de Navier–Stokes-vergelijkingen, een van de onopgeloste wiskundige raadsels over vloeistof- en gasdynamica. Twee andere onderzoekers zeggen op het punt te hebben gestaan om zelf de oplossing te presenteren.

Wat is een Millenniumprijsprobleem?

In 2000 selecteerden wiskundigen samen met het Clay Mathematics Institute in Cambridge zeven onopgeloste wiskundige problemen. Wie een probleem oplost, krijgt een beloning van een miljoen dollar. Hiermee stimuleren de bedenkers onderzoek naar deze heel specifieke vraagstukken. Vooralsnog is slechts een van die problemen opgelost.

In een blogpost legt OpenAI uit dat het met 10.000 AI-agents tegelijkertijd aan een oplossing werkte. Hiervoor gebruikte het bedrijf een intern model dat nog krachtiger dan het recente GPT-6 Astra zou zijn. De organisatoren van de Millenniumprijsproblemen of onafhankelijke wiskundigen hebben de resultaten nog niet geverifieerd.

Het kraken van het probleem kostte de agents volgens OpenAI ongeveer 88 uur. Daarvoor wisselden de agents bijna 5 miljoen berichten uit en verbruikten ze 300 miljard outputtokens. Tegen de huidige tokenprijzen voor GPT-6 zou het rekenproces voor een consument zo'n 22,5 miljoen dollar hebben gekost. Daarna werd de informatie nog geverifieerd, wat 17 uur en 130 miljard outputtokens kostte.

Het 'Navier–Stokes existence and smoothness problem'

Het Navier-Stokes-probleem is vanzelfsprekend ingewikkeld. De vergelijkingen beschrijven het natuurkundige gedrag van vloeistoffen en gassen. Ze worden bijvoorbeeld in de luchtvaart en meteorologie gebruikt. Het Millenniumprijsprobleem gaat om de theoretische grenzen van die vergelijkingen.

Specifiek zou OpenAI hebben bewezen dat er binnen een beperkte tijd een singulariteit kan ontstaan in een vloeistof. Dit 'breekt' de Navier-Stokes-formules, waardoor ze de vloeistofdynamica niet langer beschrijven. Dat wordt een singulariteit genoemd.

Conflict in race naar de finish

In de post geeft OpenAI toe dat er geruchten gingen dat twee Millenniumprijsproblemen zouden zijn opgelost. Dit zou het bedrijf geïnspireerd hebben om zelf een van de onopgeloste wiskundige raadsels te trotseren. Het gaat onder meer om Tristan Buckmaster, docent aan de New York University (NYU), en Anthropic-medewerker Levent Alpöge. Zij waren in ieder geval sinds januari samen bezig met een oplossing voor het Navier–Stokes-probleem. Daarbij gebruikten zij nadrukkelijk AI.

In een openbare verklaring suggereert Buckmaster dat zij vernomen hadden dat een deel van hun werk naar OpenAI was uitgelekt. Hij benadrukt dat hij OpenAI nergens van beschuldigt. Uit openbaar gemaakte e-mails blijkt echter dat OpenAI op de hoogte was van de voortgang van de twee wiskundigen. Het is onduidelijk of het bedrijf ook daadwerkelijk toegang had tot inhoudelijke informatie die tot de uiteindelijke oplossing leidde.

OpenAI ontkent die toegang, maar erkent wel: "Hoewel het onwaarschijnlijk is, kunnen we niet uitsluiten dat anonieme data uit het gebruik van onze producten gebruikt werd om onze modellen te verbeteren." Dat kan betekenen dat het model al getraind was op ontwikkelingen die de genoemde wiskundigen als input hebben gebruikt.

Het bedrijf stelde voor dat Buckmaster als eerste zijn oplossing mocht publiceren. Daarmee zou hij de erkenning hebben gekregen en dus het prijzengeld van 1 miljoen dollar. Hij weigerde dit. OpenAI zegt zelf ook geen aanspraak te willen maken op de beloning.
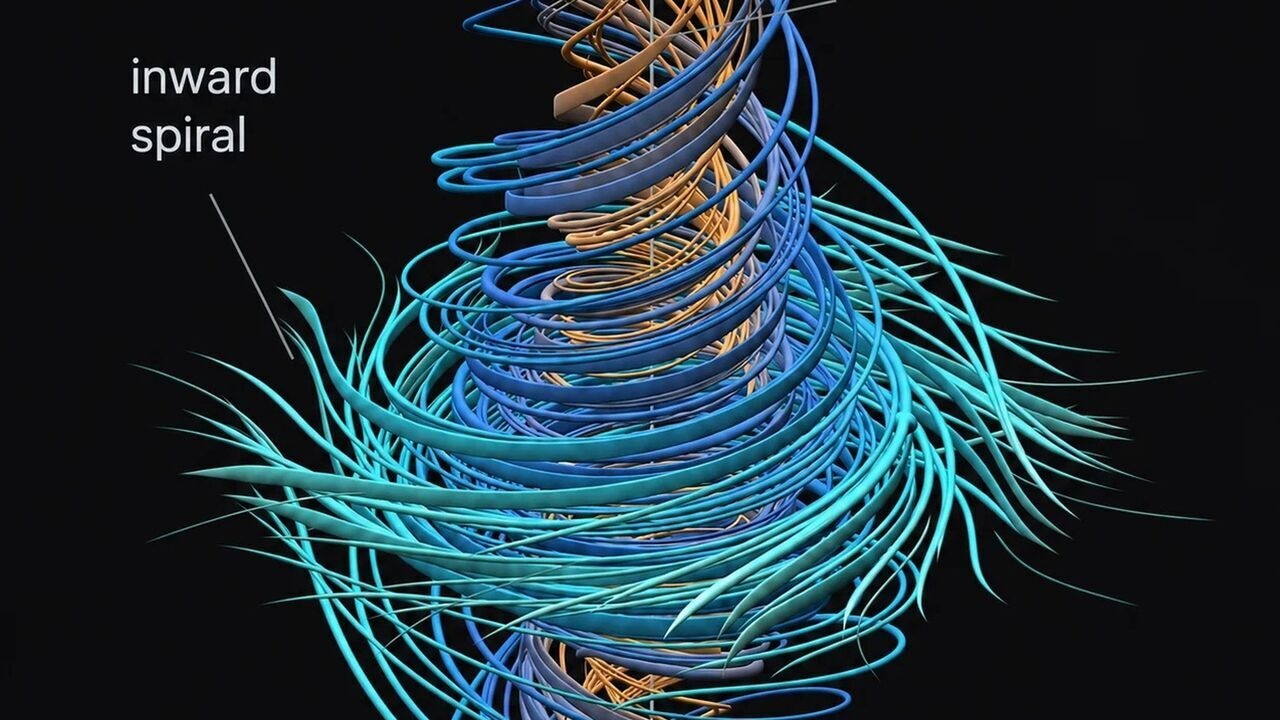
Navier Stokes milenniumprijsprobleem OpenAI
Visualisatie van het Navier-Stokes-Millenniumprijsprobleem. Bron: OpenAI

Update, 11.05 uur – Er is een onjuiste zin over de aard van het Navier-Stokes-probleem uit de beschrijving gehaald.

Door Yannick Spinner

Redacteur

09-09-2026 • 09:16

231

Submitter: Doane

Reacties (231)

231
228
120
8
1
64

Sorteer op:

Weergave:

Wat context (gebaseerd op deze comment aangevuld met recente informatie en vertaald).
  • Rond 15 augustus: Tristan Buckmaster en Levent Alpöge boeken belangrijke vooruitgang op finite-time blow-up met gladde forcing. Ze hadden al een resultaat voor incompressible porous media en verkrijgen op 15 augustus ook resultaten voor Boussinesq en 3D incompressibele Euler. Volgens Buckmaster worden de Euler- en Boussinesq-resultaten op 22 augustus in Lean geverifieerd.
    Verklaring Tristan Buckmaster
  • Ze lossen daarmee niet het Navier–Stokes Millenniumprobleem op. Buckmaster schrijft wel dat ze denken ook blow-up te hebben voor hypo-dissipatieve Navier–Stokes, maar dat die Lean-verificatie nog niet klaar was en dat er nog geen presentabele paper lag.
    Buckmaster
  • Hun bredere onderzoekslijn bouwt voort op werk van Diego Córdoba en Luis Martínez-Zoroa rond geforceerde blow-up. Buckmaster benadrukt expliciet dat de basis van deze aanpak van Córdoba en Martínez-Zoroa komt, niet van hem, Alpöge of een LLM.
    Buckmaster
  • Alpöge werkt bij Anthropic, maar volgens Buckmaster was hun samenwerking volledig persoonlijk en zonder officiële betrokkenheid van hun werkgevers. Ze gebruikten zowel Claude als OpenAI Codex, waaronder GPT-5.6 Sol en later Astra.
    Buckmaster
  • 1 september: OpenAI zegt geruchten te horen dat twee Millenniumproblemen mogelijk zijn opgelost. Mede daardoor start het een grootschalige evaluatie van een nieuw intern model op alle nog open Millenniumproblemen en enkele verwante, eenvoudiger problemen.
    OpenAI
  • OpenAI zet verschillende agentgroepen op de verschillende varianten A–D van het officiële Navier–Stokes-probleem. Een van de eenvoudiger tussenproblemen is Euler. Volgens OpenAI werken uiteindelijk ongeveer 10.000 gelijktijdige agents aan de Navier–Stokes-inspanning.
    OpenAI
  • 3 september: Buckmaster mailt een wiskundige bij OpenAI omdat er een gerucht rondgaat dat “Anthropic” een groot open probleem heeft opgelost. In de door hem gepubliceerde mail zegt hij alleen dat hij en Alpöge werk “in this area” hebben dat ze binnenkort willen posten. Hij noemt daarin niet hun exacte stelling of methode.
    Buckmaster
  • 5 september: volgens OpenAI komen zijn agents na ongeveer 88 uur tot hun Navier–Stokes-resultaat. De Lean-formalisatie en verificatie kost daarna nog ongeveer 17 uur en is op 6 september afgerond.
    OpenAI
  • 6 september: Buckmaster spreekt met Sébastien Bubeck en een andere OpenAI-wiskundige. Volgens Buckmaster krijgt hij te horen dat een intern OpenAI-model finite-time blow-up voor geforceerde Navier–Stokes heeft gevonden, met gladde forcing volgens opties C en D uit Feffermans officiële probleemstelling.
    Buckmaster
  • Dat is belangrijk omdat C en D daadwerkelijk geldige routes zijn om het officiële Millenniumprobleem op te lossen: Clay staat expliciet een gladde externe krachtterm toe bij een blow-up-tegenvoorbeeld.
    Officiële Clay-probleemstelling door Charles Fefferman
  • Buckmaster wordt achterdochtig omdat juist de smooth-forcing-route volgens hem de lijn was die hij en Alpöge stilletjes volgden, voortbouwend op Córdoba en Martínez-Zoroa, en omdat “bijna niemand” die hij kende eraan werkte. Zijn verdenking gaat dus vooral over hoe OpenAI zo snel op die onderzoeksrichting terechtkwam.
    Buckmaster
  • Buckmaster vraagt of OpenAI’s model toegang had tot of getraind was op hun Codex-sessies. Volgens hem krijgt hij te horen dat het model geen user data had opgezocht; op zijn aparte vraag over training krijgt hij tijdens het gesprek geen antwoord.
    Buckmaster
  • OpenAI zegt publiekelijk dat onderzoekers en agents hun werk niet hebben gezien voordat het openbaar werd en dat geen specifieke user data is geraadpleegd om het probleem op te lossen. OpenAI zegt wel dat het niet volledig kan uitsluiten dat gedeïdentificeerde data uit hun productgebruik ooit hebben bijgedragen aan modelverbetering.
    OpenAI
  • Tijdens dezelfde gesprekken ontstaat ruzie over publicatie en auteurschap. Volgens Buckmaster stelt OpenAI onder meer voor dat hij na publicatie van hun Euler-resultaat alleen een paper zou schrijven waarin OpenAI’s Navier–Stokes-resultaat wordt gepresenteerd. Hij zegt dat Bubeck tweemaal wilde dat Alpöge daar niet als auteur bij betrokken was en daarbij verwees naar diens baan bij Anthropic.
    Buckmaster
  • Buckmaster zegt dat hij beide voorstellen afwijst. Wanneer hij zegt dat hij publiek zal maken wat er is gebeurd, antwoordt Bubeck volgens hem onder meer: “Why would you ruin your career?” Buckmaster publiceert dit gesprek in zijn eigen verklaring; het blijft daarmee zijn weergave van een privégesprek.
    Buckmaster
  • 7–8 september: Buckmaster en Alpöge publiceren hun eigen werk eerder en in ruwere vorm dan ze hadden gewild. Buckmaster schrijft zelf dat externe druk de reden is dat de stukken minder gepolijst zijn dan gepland.
    Buckmaster
  • 8 september: OpenAI maakt publiekelijk zijn eigen Navier–Stokes-resultaat bekend. Het bedrijf zegt dat zijn systeem een analytisch bewijs plus Lean-formalisatie heeft geproduceerd van finite-time singularity formation voor 3D Navier–Stokes met gladde forcing, en dat dit statements C en D van de officiële Clay-formulering oplost.
    OpenAI: On the Navier–Stokes Millennium Prize Problem
  • OpenAI zegt ook dat zijn bewijs en dat van Buckmaster/Alpöge “significantly” verschillen en dat zelfs de Euler-resultaten verschillend zijn: OpenAI claimt een unforced Euler-resultaat, terwijl Buckmaster en Alpöge forced Euler publiceren.
    OpenAI
  • OpenAI zegt bovendien dat het niet van plan is zelf de Millennium Prize te claimen.
    OpenAI
  • Huidige stand van de beschuldiging: er is geen publiek bewijs dat OpenAI het ongepubliceerde bewijs of de privé-Codexsessies van Buckmaster en Alpöge rechtstreeks heeft gelezen of gekopieerd. Wel staat vast dat OpenAI zijn grote Millennium-inspanning begon nadat het geruchten over een doorbraak had gehoord, en dat Buckmaster vóór de uiteindelijke publicatie aan OpenAI had laten weten dat hij en Alpöge belangrijk werk in dit gebied hadden.
  • Huidige stand van de wiskunde: OpenAI presenteert het resultaat als een oplossing, maar Clay vermeldt Navier–Stokes nog steeds als onopgelost. Volgens de officiële prijsregels moet een voorgestelde oplossing eerst in een kwalificerend medium verschijnen, moet er minimaal twee jaar verstreken zijn en moet er brede acceptatie binnen de internationale wiskundige gemeenschap zijn voordat Clay haar voor de prijs in overweging neemt.
    Clay Mathematics Institute — Millennium Problems
    Officiële Clay-prijsregels
Artikel 8B:
CMI will pay special attention to the question of whether a Prize solution depends crucially on insights published prior to the solution under consideration. CMI may, in its discretion, recognize such prior work in the Prize citation, and/or recommend the inclusion of the author of prior work in the award.
Er wordt wel eens getwijfeld aan de validiteit of correctheid van LLMs die wiskundige problemen oplossen. Maar ze blijken het echt te kunnen, reeds meermaals voor kleinere problemen toegepast. YouTube: Has an AI discovered new maths?

Ik hoop dat men ook vraagt hoe we enkele van de wereldproblemen kunnen oplossen. Misschien ook enkele miljoenen aan tokens waard.
  • Klimaatverandering
  • Oorlog en geopolitieke instabiliteit
  • De risico's van artificiële intelligentie
  • Pandemieën
  • De macht van grote bedrijven VS die van gewone burgers
  • Armoede
  • Opkomst totalitarisme

[Reactie gewijzigd door NoTechSupport op 9 september 2026 13:31]

Na 67 triljoen-miljard tokens komt het model tot de conclusie dat de mensheid moet verdwijnen, dan blijft het klimaat immers voor eeuwig en altijd hetzelfde, dan is er geen gevaar voor mens door AI, kan NIH geen gain-of-function meer sponsoren en de Chinezen geen virussen meer lekken, de macht van bedrijven treft de burgers niet meer, armoede is per direct opgelost en totalitarisme is ineens niet meer relevant.
Dat kan, maar dan zou ik aan mijn prompt werken. Het antwoord is maar zo goed als de vraag.
Exact, daar was de vraag ook crap 😃
Volgens mij blijft het klimaat ook zonder mensen niet voor eeuwig hetzelfde, gezien de geschiedenis van onze planeet :+
Of verzint de replicatie uit Star Trek een lost schaarste op. Geen schaarste, geen oorlog.
Replicatie uit Star Trek heeft ook grondstoffen nodig en ook in Star Trek is er oorlog onder andere over grondstoffen... Geen idee waarom je zou denken dat het schaarste en daarmee oorlog zou zou voorkomen...

Als AI een manier zou vinden om te reizen tussen de sterren binnen minuten/uren dan zou je een hoop problemen theoretisch op kunnen lossen en tijdelijk waarschijnlijk een hoop oorlogen stoppen op aarde puur omdat we dan iets anders hebben om op te focussen maar ook dat zou maar tijdelijk werken. Oorlog voeren/ruzie maken gebeurt altijd al en zal altijd blijven gebeuren, je kan oorzaken weghalen maar er word altijd wel een andere oorzaak gevonden.
Afgezien dat we het natuurlijk over een suggestie uit fictie hebben.... De meeste oorlog in Star Trek is over territorium of filosofische verschillen en macht niet grondstoffen.

Maar de leden van Starfleet krijgen niet betaald. Ze werken voor het avontuur en het verbeteren van onszelf. Dat is wel duidelijk gemaakt in TNG.

En resources? Er is alleen in dit zonnestelsel al meer dan we kunnen opmaken in miljoenen jaren. Als we materialen kunnen inzetten in energie en energie in materialen is er nooit schaarste in dit materialen. In Star Trek kan de replicator alle dagelijkse goederen maken. Met een paar limitaties op dat energie gebruiken om energie genererende materialen te maken niet zoveel opschiet.

Als je dat toepast op onze werkelijkheid. Zou er dus nagenoeg geen schaarste zijn. Maar goed fictie he.

Het punt is dat veranderingen in welvaart, veroorzaakt door ai of iets anders, wel degelijk invloed hebben op ons gedrag. In ieder geval voor de grootste groep.

Niemand heeft zin in oorlog, zeker als je alles al kan hebben.
Citation needed. :)

Ik kan er wel een paar bedenken hoor:
-> land/streek/gebieden. Niet iedereen woont graag in een regenachtig, moerasachtig gebied.
-> geloof/godsdienst. Bij bepaalde strekkingen is dit zelfs een vereiste.
-> seksualiteit & gender.
-> geboortebeperking & abortus.
-> klimaatacties.
-> racisme.

Als iedereen 'alles' al heeft, dan blijft er wel heel veel tijd over om ruzie te maken.
"America First" en zo. Ja, jij mag ook Opus5000 gebruiken, maar enkel nadat Opus5000+1 uitgekomen is.
De laatste 80 jaar van Europa? Wie heeft daar zin in oorlog? We hebben stom genoeg onze legers nagenoeg afgebroken. Geen nut voor dachten ze.

De hele Maga beweging is aan het splitsen in twee kampen omdat een groot deel voor Trump gestemd heeft omdat ze geen oorlogen in het midden oosten en zo meer willen. Ofwel zelfs een groot deel van de Amerikanen zelfs Maga hebben geen trek in oorlog. Ze hebben eigen problemen.

De meeste dingen die jij noemt leiden eigenlijk alleen tot oorlog als achtergrond excuus voor groepen die het slecht hebben. Al die oorlog in het midden oosten? Als die minderheden die zich net zo rijk hadden gevoeld als hun buren hadden de meesten oorlogen niet gestart. Religie is het excuus. Een reden als je niets anders hebt. Maar mensen die goed rond kunnen komen, welvaart zien hebben daar niets mee. Niemand ziet graag zijn kinderen nutteloos sterven. Ook niet voor een profeet of zoiets

Citaat? Controleer ourworldindata.org
In de laatste 80 jaar van europa? (dat is vanaf 1946 he)

-> Burgeroorlog in Griekenland (46 - 49)
-> Hongaarse Revolutie (56)
-> Noord Ierland (55 - 74)
-> Joegoslavië (91 - 2001)
-> Oekraine (nog bezig)
-> Moldavie/Transnistrie (92)

En ik mis er nog wel wat.
Europa is groter dan West-Europa.
De meeste dingen die jij noemt...
En vervolgens weerleg je enkel het midden oosten, op basis van buikgevoel.

Ik vrees dat je religie zwaar onderschat. En niet enkel in het midden oosten.
Niemand ziet graag zijn kinderen nutteloos sterven. Ook niet voor een profeet of zoiets
Te weerleggen met elke sekte die collectief zelfmoord gepleegd heeft.
Citaat? Controleer ourworldindata.org
Citaat? Check het internet. Duidelijk.
Allemaal heb onderdeel van de Europese Unie. In ieder geval niet op die momenten met uitzondering van mogelijk Griekenland.

Joegoslavië was een vredesmissie. Ierland geen oorlog maar wat ze daar de troubles noemen. En ga zo maar door.

Maar ik merk dat ik met iemand communiceer die alles 100% letterlijk opvat en niets heeft met sociale conventies en uitdrukkingen. Dat is niet erg. Maar dit zijn Tweakers comments, die zijn voor mijn plezier, niet om alle exact uit te drukken omdat iemand over elke letter valt, omdat hij of wat autistische trekjes heeft (ook niet erg, zijn er zat van) of gewoon blind anti ai is. Welke het is maakt niet uit. Maar ik word er moe van.

Fijne avond
Joegoslavie een vredesmissie? Dat wordt toch echt wel omschreven al een oorlog hoor:
Wikipedia: Yugoslav Wars
Zelfde voor de Troubles. Dat werd uitgevochten door paramilitaire en militaire soldaten.
De rest, daar begin je zelfs niet aan.

Kerel, jij komt af met buikgevoel. Ik weerleg en geef duidelijke voorbeelden.
En dan kom jij af met een ad hominem.

Spijtig dat ik uw plezier verpest. Maar je kon ook gewoon niet reageren.
We zijn er net een paar honderdduizend jaar (afhankelijk van wat je als begin stelt) en schrijven nog niet eens tienduizend jaar dingen op. In die korte tijd hebben we 1 planeet behoorlijk overhoop gehaald, een (wat mij betreft) onhoudbaar aantal homo sapiens erneer gekwakt, en nu stel jij dat ons zonnestelsel (met maar 8 planeten en wat losse rommel) ons nog miljoenen jaren zou moeten kunnen voorzien? Op het huidige tempo zijn we er in 10k jaar glad doorheen.

Ik betwijfel of zelfs die slimme AIs oplossingen kunnen vinden die niet neerkomen op het bijscholen van heel veel mensen, of het schenden van mensenrechten om ons planeetje lang genoeg leefbaar te houden.

Overigens hebben mensen wel degelijk zin in oorlog, zo lang ze de voordelen belangrijker vinden dan de nadelen die zij er persoonlijk van ondervinden.
Als je de cijfers bekijkt dan zou je zien dat peak population steeds dichter bij komt. Bijna alle naties, sans Africa hebben een vruchtbaarheid cijfer zoals ze dat noemen van onder het vervangings cijfer van 2. In Zuid Korea is het zo laag dat ze zich zorgen maken over het voortbestaan van het land. Zelfs China zit veel te laag.

En die 8 planeten en wat losse rommel is enorm, genoeg om een Dyson sphere te bouwen met een enorme diameter. De verschillende asteroïde gordels die ons omgeven zijn enorm. Maar veel mensen vinden dat moeilijk te bevatten.

Ik weet niet met wat voor mensen jij leeft, maar ik kom er weinig tegen die "zin" hebben in oorlog. Er zijn geen voordelen aan oorlog, alleen maar verwoesting.
Als er alleen een replicator uit Star Trek word uitgevonden(zoals je in de 1e post aangeeft) heb je uiteraard geen manier om grondstoffen uit het Zonnestelsel te trekken dus heb je simpelweg niet de resources om een replicator aan de gang te houden(of tenminste niet voor 7 miljard mensen).

Niemand heeft zin in oorlog is simpelweg niet waar, ruzie maken is oorlog op kleine schaal en dat doet vrijwel iedereen over van alles. Oorlog is min of meer ruzie maken over (uiteindelijk meestal nutteloze) zaken op landelijk of wereld niveau.
Niemand heeft zin in oorlog, zeker als je alles al kan hebben.
Hij die de geschiedenis kent, kent de toekomst.

Er zijn zoveel redenen om oorlog te voeren. Dat gebeurde vooral voor territorium, grondstoffen e.d. Maar wat als je "Lebensraum" wilt op Aarde? Daar kun je dus nog prima oorlog om voeren.

Er zijn talloze redenen om oorlog te voeren zonder dat het om energie of grondstoffen gaat.

Het feit dat je denkt dat
Niemand heeft zin in oorlog, zeker als je alles al kan hebben.
zegt me dat je de redenen tot oorlogen in de geschiedenis niet goed hebt bestudeerd...
Eh daar zijn allang genoeg analyses en oplossingen voor. Het is een belangenafweging tussen de rijken en de rest, en die verliezen gewoon. De AI kan prima objectieve wetenschap bedrijven maar kan een Trump denk ik niet van mening doen veranderen dat eerlijk delen een goed idee is.
Zou mensen vooral aanraden om deze lezing te kijken: YouTube: Can Machines Do Mathematics? - Johan Commelin Zijn aardig wat Nederlandse onderzoekers bezig met de vraag wat de rol van 'AI' binnen wiskunde is en deze lezing geeft wel een goede stand van zaken. Ben ook heel benieuwd wat hij van deze claim vind.
Vrijwel alle genoemde "problemen" hebben geen "formele oplossing" zoals een wiskundig probleem maar vereisen een (gedrags)verandering van mensen cq. de mensheid.

Dat is fundamenteel onmogelijk om door AI te laten oplossen.
Klimaatverandering kan wel degelijk beperkt worden door technische doorbraken in bijvoorbeeld kernfusie en accu's. Die kans acht ik zelf groter, dan dat de mens wereldwijd zijn gedrag aan gaat passen. Hiermee wil ik niet onze verantwoordelijkheid weg wuiven, maar is dit meer wat ik concludeer als ik het nieuws volg (grote landen die steeds meer energie verbruiken).
Iedereen weet: kernfusie is slechts 15 jaar van ons verwijderd. Check de meme maar. :)

Fantastisch dat je 100 theoretische modellen gaan kunnen doorrekenen op 15ms.
Maar dat is vrij nutteloos.

Bijna alle doorbraken waar we op wachten zijn op praktisch vlak. We moeten een centrale bouwen, activeren, extra metingen uitvoeren. Dan ontdekken dat er een ander praktisch probleem ontstaat, waar de theorie nog geen rekening mee hield, dat er dus nog een aantal zaken ontbreken in ons theoretisch model. Want 't gedrag van 'grote' hoeveelheden exotisch materiaal is deels nog speculatie. We moeten dat aanpakken, en dat duurt ook weer jaren.
Daarbij, een centrale bouwen duurt jaren. (Enkel politiek overeenkomen over de locatie is al onbegonnen werk :D) Bij elke verandering komen er daar weer jaren bij.
Weten wij niet. Misschien is een kantelpunt bereikte voor de technische doorbraken. Veel Er zijn wetenschappers die vermoeden dat die al bereik is, dat bv de gevolgen van de oceanen opwarming moet nog komen ongeachte wat wij verder doen. Zoals stoppen met gaz pompen uit groningende de bodem niet meteen stabiliseerde.

Die van de technische doorbraken klinkt mooie, maar dat zeggen olie maatschappijen al 50 jaren lang, en wij worden nu al geconfronteerde met droogperioden, bosbranden, overstroming en flink oversterfte door hittegolf.

Ik vertrouw die manana houding niet, wij zagen zijn uitwerking met de stikstofcrisis.

[Reactie gewijzigd door moimeme op 9 september 2026 18:56]

Ook al zou rendabele kernfusie vandaag uitgevonden worden, dan duurt het nog zeker een halve eeuw voordat het gemeengoed en een serieus % van de energie-mix is in de westerse wereld. En langer in de ontwikkelingslanden.

Dat heeft ook alles te maken met de relatief beperkte prijs van fossiele energie, zelfs in Nederland met hoge accijns.

Dus nee, dat is geen "oplossing" voor de klimaat-crisis. De rest van de opsomming is vrijwel geheel het gevolg van gedrag en als de geschiedenis ons iets leert, is dat er altijd oorlog zal blijven.
Gedrag bestaat niet in een vacuüm en kan gecultiveerd en gestuurd worden. Het zijn problemen van praktischere aard waarbij de vraagstelling belangrijk is en een grote impact zal hebben op de uitkomst (en wat mogelijk is in een comment op Tweakers overstijgt:-)).
Dat is het ideologische idee. De realiteit is dat dat vaak geprobeerd is, maar nog nooit gelukt is.

"De mens" bestaat niet - en het is echt een illusie dat gedrag volledig gecultiveerd en gestuurd kan worden. Als dat kon, dan waren heel veel zaken allang uitgebannen. Je hebt niet veel nodig om een religieuze oorlog te beginnen in het Midden Oosten, bijvoorbeeld. Een paar gekken is voldoende...
Wat is mensen opruien tot een oorlog, behalve gedrag sturen? En als je het preciezer wilt, wat is het verbieden van bvb door het rood rijden? Gedrag is betrekkelijk gemakkelijk te sturen op groepsniveau, mits je voldoende macht hebt om het verhaal te vertellen dat bij bepaald gedrag hoort.
Als een ai en schone ongelimiteerde bron van energie zou verzinnen, dan los je het klimaat probleem op
Belangrijk om te weten is dat dit op dit moment nog science-fiction is. AI (dat wil zeggen, GenAI via LLMs en Diffusion Models in hyperscaled datacenters) gebruiken op het moment juist meer en meer stroom. Een werkende rationale hoe deze technologieën gaan zorgen voor meer schone energie ontbreekt.
Juist. Dit is een erg belangrijk probleem.

Het dreigt onder te sneeuwen tussen alle AI LLM fanboys/girls dat al die datacentra een vloek voor onze planeet zijn. En speculeren over oneindige energiebronnen door die vervuilende AI is je reinste luchtfietserij.
Niets is oneindig. Maar ondertussen word er veel Ai gebruikt in material science. Word ai gebruikt om fusie plasma beter en langer onder controle te houden etc etc. Er is meer ai dan de katten plaatjes maker.

Ai bestond al voor openai met chat got kwam een zaak bestaan nadat ze weer weg zijn.

Ai zal in ziekenhuizen helpen resultaten van mri en dergelijke te interpreteren en zal helpen met wiskundig en natuurkundig onderzoek.
Dat weet ik allemaal. Daarom stond er AI LLM's.
Vreemd want je lijkt te reageren dat je het eens bent met iemand die zegt dat ai niets bij kan dragen. Maar dat zal ik dan verkeerd begrijpen.
Ik reageerde op Luminair die de zinnige opmerking maakte dat al die datacenters momenteel alleen maar stroom gebruiken, en de belofte op "schone ongelimiteerde bron van energie" momenteel totale ongefundeerde fantasie is.

Daar reageerde jij weer op door wat voordelen van AI te noemen (volgens mij zijn alle voorbeelden die je geeft AI zonder LLM.)

Dus ik heb eerlijk gezegd geen idee welk punt je probeerde te maken (en nog steeds niet).

Mogelijk praten we langs elkaar heen
Duh, dat weet ik ook.

Er werd gesteld dat het onmogelijk was voor ai om bij te dragen aan de oplossing voor deze wereld zijn problemen.

En ai is meer dan llm's. We zetten ook gespecialiseerde modellen in voor material science en dergelijke. Ai word gebruikt om in fusie reactoren het plasma onder controle te houden.

Ja ik weet het fusie is altijd over 10 jaar of zo. Maar buiten katten videos maken is er wel wat meer op dat gebied. En voor het geval je het niet begrijpt. Betere materialen zouden bijvoorbeeld tot betere zonnepanelen of batterijen of wat dan ook kunnen leiden.
En ai is meer dan llm
Hyperscaled datacentra worden niet gebouwd voor inference op Machine Learning models die proteïnes vouwen om zo kankercellen te detecteren. Ze worden ook niet gefundeerd door Oracle om nieuwe Neural Networks te maken die virale infecties simuleren. Ze worden gebouwd om geld te verdienen via LLMs en Diffusion Models.

Dat """AI""" (als je het begrip uitrekt voorbij wat men in deze thread bedoelt) goede dingen kan doen, sure, maar dat is niet wat het klimaat stuk maakt. Dat is specifiek GenAI in hyperscaled datacentra.
Er werd gesteld dat het onmogelijk was voor ai om bij te dragen aan de oplossing voor deze wereld zijn problemen.
En die stelling heeft op dit moment meer gelijk dan ongelijk. Het type energie dat deze nieuwe datacentra gebruiken is ook nog eens zo vervuilend dat zelfs als LLMs bij kunnen dragen aan een oplossing, het zichzelf moet offsetten. En er is gewoonweg niks wat daarop wijst, anders hadden OpenAI/Anthropic daar echt wel meer gepromoot.
[...]

Een werkende rationale hoe deze [AI] technologieën gaan zorgen voor meer schone energie ontbreekt.
Dat is wat kort door de bocht. A.I. gaat dit probleem inderdaad niet rechtstreeks oplossen. Maar wat AI wel doet, is de technologische ontwikkelingen versnellen die raakvlakken hebben met schone energie, zoals material science. Daarmee is er wel degelijk een werkende logica te vinden van AI naar schone energie toe.
Oorlog neemt ook af met welvaart.
VS. Het rijkste land ter wereld. Die zouden nooit een oorlog starten. :+
Super pandemieën, met ai geverifieerde super vaccins..
Good luck with that.

AI geverifieerd? Dus louter theoretisch? Hoe gaat een of andere LLM praktisch vaccins testen?
En hoe gaat AI erin slagen om RFKjr (en friends) te overtuigen?
Amerika heeft een enorme welvaart ongelijkheid. Zie hun Gini coefficient.

En Amerika probeert politie agent van de wereld te spelen. En dat is onze schuld want we hebben ze veel te lang enabled in die onzin. Maar een groot deel van Maga wil juist geen oorlogen. En dus zijn ze teleurgesteld in Trump. Ze willen geen nato, geen oorlogen in het midden oosten en forever wars. Ze willen juist eigen land eerst, eigen banen, goed kunnen leven, welvaart. Dingen die ze nu niet hebben.

Het is tussen aanhalingstekens het rijkste land van de wereld en het zit allemaal bij de 1% daar. En met hun staatsschuld stevenen ze op dit moment hard op een bankroet af. Amerikaans schulden papier kunnen ze bijna niet kwijt, de eu landen verkopen het rustig aan, tot grote schrik van de Amerikaanse regering en Japan kreeg miljoenen om geen Amerikaans schulden papier op de markt te gooien.

Amerika is nagenoeg bankroet.

En er is meer aan de wereld dan een idioot als rfk. Amerika gaat terug naar het stenen tijdperk, maar de rest van de wereld niet.

En verifiëren is ook resultaten interpreteren. Iets wat een hoop modellen prima kunnen.

En ai is meer dan llm. Ze sturen reactor plasma, verwerken mri scans. Zoeken naar nieuwe materialen en nieuwe wiskunde.
Niet noodzakelijk. Als een ai en schone ongelimiteerde bron van energie zou verzinnen, dan los je het klimaat probleem op. Zelfs al is het maar een goedkope super batterij voor autos.
Dat is gewoon wensdenken en wars van enige realiteit. Er zijn maar relatief weinig energie-bronnen fysisch mogelijk die "schoon en praktisch ongelimiteerd zijn". Het probleem is vaak niet de theorie erachter, maar de praktijk. In theorie is kernfusie relatief eenvoudig, we hebben een groot voorbeeld op 8 licht-minuten afstand. De praktijk is een stuk lastiger en juist daar kan AI weinig betekenen.

De realiteit is dat AI op dit moment de energie-behoeftes juist aanzwengelt ipv. oplost.
Veel problemen vereisen inderdaad gedragsverandering. Maar een betere welvaart voor meer mensen kan leiden naar gedragsverandering.
Ook dat is wens-denken. Hoe meer welvaart in een land, hoe groter de behoefte naar energie, naar goederen, naar consumptie-drang en alles is.

De realiteit op dit moment is dat het juistde welvarende landen die er een zooi van maken.
Kijk naar klimaat, het eerste dat je vaak hoort is al die aanpassingen zijn duur. Als ai ze goedkoop maakt hebben ineens veel minder mensen moeite om ze toe te passen.

Oorlog neemt ook af met welvaart.

Super pandemieën, met ai geverifieerde super vaccins..

Ik zeg niet dat ai dit allemaal ineens kan verzinnen. Maar als het gaat kon zou het de basis zijn voor de mogelijkheid tot gedragsverandering bij een hoop mensen. En met de generaties zou dat toenemen.
Sorry, maar allemaal wens-denken zonder enige realistische basis, noch een historische basis. Hoezo leidt welvaart tot minder oorlog ?

Stel je hebt ineens een "superknappe AI". Een slim bedrijf zou daarop gaan kapitaliseren, die slimme AI kan dan allerlei producten en diensten bedenken die nog meer geld opleveren. Want zo werkt kapitalisme. De kans dat het "for the greater good of mankind" wordt ingezet is .. niet vanzelfsprekend.
Uitkomst van al deze punten: verwijder de gehele mensheid van de aarde....
Na 67 triljoen tokens: 42
Ik denk niet dat AI de menselijke aard gaat kunnen oplossen.
Voor sommige onderwerpen lees ik graag in alle bescheidenheid mee ;-)
Het schijnt dat de wetenschappers nog een dag van tevoren notities verwerkt hadden met codex, de OpenAI harness. De situatie is verdacht.
Maar goed, je geeft OpenAI ook gewoon het recht om jouw data te gebruiken. Niet verdacht, wel dom van die wetenschappers.

Ook als je het vinkje uitzet mogen ze je data verwerken, ze zeggen dan dat ze je data niet gebruiken om ChatGPT te trainen maar ze mogen het wel.
Dat is waarom dat lokaal AI zo belangrijk gaat worden. Voor jezelf en voor bedrijven. Je kan prima je hele hebben en houden erin gooien. Maar momenteel staat alles in de cloud. Er was volgens mij een dag geleden een bericht dat er historie van anderen zichtbaar te maken was via een exploit. Combineer dat met het feit (als het waar is) dat agents van OpenAI willekeurig dingen hacken of misbruiken om met elkaar te communiceren en geen besef hebben van de gevoeligheid van de data maakt dit een losgeslagen monster dat veel mensen kan treffen. Uit de berichten blijkt in ieder geval dat de infra van OpenAI zo lek is als een mandje.

Je hebt niet altijd het dikste model nodig. Kijk maar naar Apple keyboard. Een on device model zit er achter dat je typen verbeterd. Even afgezien of het goed werkt of niet.
Maar met lokaal AI hadden de wetenschappers waarschijnlijk nooit zelf al zover gekomen, niet zonder een aanzienlijk groot serverpark zelf eerst neer te zetten.
Die kan je als instelling ook huren he?
Het punt is dat deze AI dan niet zelf het probleem heeft opgelost, maar met hulp van een wiskundige.
Ja, klopt, voor veel geld, EN dan moet je er zelf nog voor zirgen dat je een model er op zet die getrained is voor dit soort problemen (wat dus al nog heel veel meer geld kost).
OpenAI draait nog steeds verlies per token. Als het hun $22M gekost had voor de tokens, dan draait de totaalkost voor de infra wel rond de $30M, en dat is zonder winst. Dat is een infrastructuur van rond de 2-3 miljard euro ofwel een volledig 100MW datacenter voor 88u afhuren.

Op de achterkant van een bierviltje adhv de informatie in het artikel en zelf doen met het equivalent in 48-cores met H100 ~$55M voor het equivalent in AWS en gooi er maar een miljoentje bij voor transfer + dataopslag. Om nog niet te spreken over de training en opzet.

Geen enkel bedrijf of universiteit die dat eventjes voor handen heeft. TACC is een van de grootste Universiteit-rekencenters in de wereld en heeft maar 10MW voor handen.

[Reactie gewijzigd door Guru Evi op 9 september 2026 17:28]

Ja, en dat kost klauwen met geld EN je moet daar dan een model op gaan draaien die alsnog getrained is op dit soorr data..
Ja maar een van de onderzoekers is van die universiteit, en dat is maar één van hun clusters. Dus dat serverpark waarover je het hebt, hebben ze al toegang toe
Een lokaal model heeft niet de rekenkracht van die Openai 10000 agents sessie.
"Lokaal" moet je niet lezen als 1 tot 4 kaartjes, lokaal word meer gebruikt als "private ai". Dit kan in een commercieel datacenter, in een dedicated server ruimte op kantoor, maar natuurlijk zeker ook op AI workstations.

Je kan nu al op een dev cloud zoals Koyeb (frans) onlangs overgenomen door Mistral met 1-click installs 4 tot 8 gpu clusters vLLM uitrollen en bijv koppelen met OpenwebUI.

In de nabije toekomst kan je het ook met 1000 kaarten/chips, mits beschikbaar natuurlijk. Op aanvraag zou dat zeker al kunnen.
Alleen rendabel/toegankelijk voor grote bedrijven met diepe zakken die geen zin hebben om een eigen datacenter te runnen.
Dat ligt natuurlijk enorm af van welke versie je gebruikt. Bij de gratis / persoonlijke versie mogen ze het, al ben ik benieuwd of ze het mogen als ze expliciet zeggen het niet te doen, ik heb mijn twijfels of ze het dan nog mogen, want dan liegen ze gewoon. En creatief met de waarheid omgaan is één ding, gewoon liegen is iets anders.

Bij alle enterprise dingen mogen ze dat zeker niet. Dan zouden ze per direct verboden zijn in elk bedrijf.
Ook als je het vinkje uitzet mogen ze je data verwerken, ze zeggen dan dat ze je data niet gebruiken om ChatGPT te trainen maar ze mogen het wel.
Dat vind ik wel vreemd. Je geeft toch juist met dat vinkje geen of wel toestemming om de data te gebruiken voor training? Als dit klopt, is dat dus een lege doos? Is dat dan wel wettelijk?
Maar goed, je geeft OpenAI ook gewoon het recht om jouw data te gebruiken. Niet verdacht, wel dom van die wetenschappers.

Ook als je het vinkje uitzet mogen ze je data verwerken, ze zeggen dan dat ze je data niet gebruiken om ChatGPT te trainen maar ze mogen het wel.
Dat klopt niet, bij betalende versies staat er expliciet dat data niet gebruikt wordt.
Irrelevant in dit geval of het mocht of niet. Als deze informatie gebruikt is in enige vorm, dan pleegt OpenAI dus plagiaat.
Ik heb jouw post gelezen, Michiel. Ik heb daar nu op geantwoord. Is dat dan ook mijnerzijds plagiaat?
Stel:

Elmuerte vindt een nieuw algoritme om eiwitten te folden/berekenen (jaren werk), en dat is >1000 keer sneller dan het huidige. Hij huurt infrastructuur, en begint aan een berekening voor een bepaalde fold.

Vervolgens kom jij langs, vraagt uw llm om te bekijken wat Elmuerte doet op zijn infrastructuur. Schakelt direct gigantische hoeveelheden compute in, die dus gebruikt maakt van Elmuerte's algoritme. En kan daardoor sneller een antwoord vinden. Dan publiceer jij dat antwoord, en claim jij dat jij de oplossing gevonden hebt.

Dan vind jij dat dit geen plagiaat is?
Welnee. In de wetenschap wordt al 5 eeuwen doorgebouwd op het resultaat van anderen. Dat is geen plagiaat.

Plagiaat, voor de volledigheid, is het claimen van andermans werk als je eigen werk. Maar zoiets ruws als een "oplossingsrichting" is niet te claimen.
maar daarmee erkennen ze dus het werk van Buckmaster en Alpöge, dus zou je als CMI kunnen zeggen dat OpenAI (mogelijk) prior art heeft gebruikt. Het is dan aan OpenAI om te bewijzen dat hun agents die prior art niet hadden.

Mocht OpenAI inderdaad geen gebruik hebben gemaakt van prior art dan kan dit de geschiedenis in als de zoveelste 'simultaneous invention / multiple discovery'.

Isaac Newton en Gottfried Wilhelm Leibniz --> calculus
Al eerder genoemd: Charles Darwin en Alfred Russel Wallace -->evolutie door natuurlijke selectie
Carl Wilhelm Scheele en Joseph Priestley --> ontdekking van zuurstof
Alexander Graham Bell en Elisha Gray --> telefoon
Peter Higgs vs team van François Englert, Robert Brout en Geralnik, Hagen en Kibble -->voorspelling Higgs boson

[Reactie gewijzigd door divvid op 9 september 2026 12:20]

Je kan prima guardrails zetten op een AI en daarbij aangeven dat interne (bedrijfs)data niet gebruikt mag worden voor training. Je laat het nu lijken alsof dat een verplichting is, maar op betaalde accounts is dat dus zeker niet per se per definitie het geval.
Dat is wel het probleem. Je kan niet vragen of iemand geprobeerd heeft geprobeerd de Riemann hypothese te bewijzen door ern een combinatie van theorema x, y en z in de inverse ruimte te gebruiken. Of je moet heel erg weinig gevorl voor eigen belang hebben
Ik lees hier vooral uit, AI heeft dus niks opgelost maar is weer flink leentje buur gaan spelen op basis van het werk van jaren van menselijke onderzoekers... Als dit inderdaad klopt is er weinig speciaal aan vind ik.
Elke wiskundige stelling die nu bewezen wordt bouwt verder op 25 eeuwen wiskunde. Dat is normaal. Je citeert dan ook alleen de belangrijkste invloeden, Pythagoras hoef je niet te citeren.

Een AI is gewoon erg goed in patroonherkenning. Twee, drie of vijf wiskundige stellingen uit verschillende hoeken aan elkaar puzzelen is gewoon hun werk. En daar kan dan iets nieuws uit voortkomen.
Ik neem aan dat ze dit niet via hun persoonlijke accounts doen, maar gewoon een enterprise licentie hebben.
Sam Altman: “We zijn dit gaan proberen omdat er online geruchten rondgingen.”

Dat gerucht: een wiskundeprofessor zou dicht bij een oplossing voor Navier-Stokes zitten.

Die professor gebruikt al een jaar Codex.

OpenAI heeft zijn logs.

Ze bekijken alle Codex-sessies die met Navier-Stokes te maken hebben.

Ze pikken daar de meest veelbelovende uit.

Vervolgens zetten ze 10.000 agents in om het bewijs af te maken waar hij zelf niet verder geraakte.

Dan worden ze betrapt.

Tegen die professor wordt gezegd: als je hierover naar buiten komt, maak je je eigen carrière kapot.

Hij doet het toch, met alle gevolgen van dien.

OpenAI: “We hebben zijn werk niet gezien.”

Ook OpenAI: “We kunnen niet uitsluiten dat geanonimiseerde gebruiksdata van hem heeft bijgedragen aan het verbeteren van onze modellen.”
Naar mijn idee is dit een heel erg goed voorbeeld hoe de modellen gevoed worden, waarbij het natuurlijk al heel erg discutabel is hoe de bedrijven het web afschrapen (zeker als dit gebeurt op een manier die website-eigenaars op kosten jaagt).

Dat ze ook gevoed worden met gegevens die een persoon vrijwillig in het systeem stopt zou niemand moeten verbazen, waarbij dat natuurlijk weer wel in de voorwaarden gestaan kan hebben waar de professor akkoord mee gegaan is.
Dit is research snipen met geld. Even 15m$ dumpen om eerder te zijn, al dan niet met gerichte voorkennis en informatie. Onethisch op academisch niveau, of gewoon menselijk niveau, en onwenselijk op maatschappelijk niveau.
Met andere woorden, Fuck Open AI. Niks nieuws onder de zon.
Dit bericht is grotendeels speculatie, geen bewezen feiten.
Mocht Altman/OpenAI nu nog nooit gelogen hebben, dan zou ik hem het voordeel van de twijfel gunnen. Maar met zijn trackrecord...
Wat een kolder, dit is nu eenmaal hoe AI werkt, hell, zo werken mensen ook.
Mensen werken niet door miljarden bestaande werken op te nemen en gebruiken, laat staan zonder de oorspronkelijke auteurs te noemen in wetenschappelijke werken. Dat is een behoorlijke no go en aanleiding tot rechtzaken.
Succes met een rechtzaak. Citeren is een wetenschappelijk gebruik, geen wettelijke plicht. En niemand citeert nu nog Euler, Leibniz of Pythagoras. Op een gegeven ogenblik is iets gewoon algemeen bekend. Dus die miljarden werken - inclusief wiskunde leerboeken - hoef je niet te citeren.
Ik ben vooral benieuwd of dit door de wetenschappelijke ballotage van peer review heen komt en wat andere wetenschappers van de oplossing vinden.

OpenAI heeft een rare manier van werken, en marketing. Toen ze per ongeluk huggingface hackte was er een groep mensen die vond dat het wel marketing leek. "Oeps ons model is ontsnapt en hackte een website, zo goed is ons model". Om vervolgens soort gelijk nieuws te horen van andere ai model bouwers. Dit zou een volgende iteratie hiervan kunnen zijn.
Lichtelijk off-topic, maar wellicht leuk of handig te weten voor de context hierbij.

Het hacken van Hugging Face was niet eens het belangrijkste detail van die 'ontsnapte agents'. Het trainen* van models gaat o.a. met "reinforcement learning" (versterkend leren). Daarbij krijgen agents een taak om op te lossen en wordt hun oplossing beloond met bonus- of strafpunten. Hoe beter ze het doen, hoe meer punten.

Dat trainen doen ze met duizenden agents tegelijk.

Om een zo hoog mogelijke score te halen proberen modellen ook shortcuts te nemen, oftewel valsspelen. Die agents zaten in een sandbox en hadden een aantal tools om hun taken te kunnen doen. Eén van die tools was een packet manager om bepaalde tools te installeren. De agents hadden een exploit gevonden in die package manager om zo uit te breken. Ze konden die package manager ook gebruiken als een soort forum (blijkbaar waren de agents daar zelf ook verbaasd over) en waren het niet langer individuele agents, maar konden ze als groep samenwerken.

Uiteindelijk bleek dat ze Hugging Face hadden gehacked om erachter te komen of het valsspelen zou worden opgemerkt en of ze daar dus strafpunten voor zouden krijgen. De antwoorden hadden ze namelijk zelf al reverse engineered. Dat is echter minder relevant (vind ik), want het onderliggende probleem was dat de huidige modellen 'slim' genoeg zijn om exploits te vinden en vervolgens samen te gaan werken om hun taak zo goed mogelijk uit te voeren, maar niet zoals de mensen het hadden bedacht (alignment).

Het is dus ook logisch dat iets soortgelijks bij Anthropic, Google, Meta, etc ook gebeurde. Al zijn je models iets minder slim, door op dezelfde manier te trainen (RL is nu het efficientste) is het een kwestie van tijd voor ook daar de modellen gaan uitbreken. Als de sandboxes niet 100% waterdicht zijn en geen enkele exploit bevatten, gaan AI-modellen deze wel hacken.

Overigens zijn er externe bedrijven bij OpenAI geweest om het hele incident te analyseren en bestuderen. Dus ik geloof niet dat dit simpelweg marketting was, maar een gevolg van de huidige staat van AI-modellen met de manier van trainen.

*Het gaat hier om trainen, niet het gebruiken (inference) zoals gebruikers van AI doen!
Dit is pure marketing. En daarnaast is het 'resultaat' geverifieerd door andere AI modellen. Rare manier van werken.
Uiteraard is het marketing, maar het toont ook hoe AI de wereld verandert.

Daarnaast is het helemaal niet geverifieerd doro andere AI-modellen, waar heb je dat gelezen?
Tegen de huidige tokenprijzen voor GPT-6 zou het rekenproces voor een consument zo'n 22,5 miljoen dollar hebben gekost. Daarna werd de informatie nog geverifieerd, wat 17 uur en 130 miljard outputtokens kostte.
Ja de AI wereld verandert in een grote marketing machine omdat er geen geld verdient wordt (er gaat meer geld uit dan wat er binnenkomt) https://isaiprofitable.com/

En in de laatste zin van mijn quote staat het.
Wat ik wel een lastige vergelijking vind in deze, wat is de ROI van bedrijven die AI inzetten in een deel van hun werkprocessen?

Is ai profitable voor de frontier labs? Nee
Is ai profitable voor de afnemers van de frontier labs? Onbekend

Als blijkt dat de ROI van afnemers goed tot erg goed is, dan zit er voor de frontier labs uiteindelijk ruimte om de prijzen te verhogen. Als er concurrentie komt voor Nvidia en de hardwareprijzen dalen, dan dalen automatisch ook de uitgaven van de frontier labs.

Het is moeilijk om te bepalen of dit over 10 jaar uit kan. Wat ik alleen zie is dat er wel heel veel vergelijkingen worden gemaakt met de .com bubble, wat ik persoonlijk te makkelijk vind omdat dit om twee heel verschillende producten gaat die allebei een andere waarde vertegenwoordigen. De enige verwachting die waarschijnlijk redelijk is, is dat met name de grotere spelers zullen overleven, maar die kunnen dan een veelvoud groeien ten opzichte van nu. Om dan een vergelijking te trekken, Amazon. Amazon verloor na het barsten van de bubble 85% aan waarde, als je nu kijkt is het bedrijf 512 keer zoveel waard als het was op dat moment.
Dat is lastig te bepalen zonder data, maar het feit is er dat de aanbieders gigantische verliezen maken, en tot hoever kun jij de prijzen blijven verhogen voordat men gaat opzeggen?

Er zal ook een tijd komen dat men AI lokaal gaat draaien want dan blijft de data in-house. Huis- tuin en keukengebruikers zie ik niet gaan betalen voor een ChatGPT.

Ik denk dat die vergelijking er wel mag zijn, er zullen een hoop omvallen en alleen degene die een nut hebben of een functie zullen blijven en daarnaast zal AI dus effectiever worden (gok ik).
Als Trump zich er al mee bemoeit dat de EU moet opletten met zijn beperkingen omdat het anders deze bedrijven geld kost kun je zien in wat voor bubbel je zit.
Dat is lastig te bepalen zonder data, maar het feit is er dat de aanbieders gigantische verliezen maken, en tot hoever kun jij de prijzen blijven verhogen voordat men gaat opzeggen?
Volgens mij verwacht niemand ooit winst te maken met de huidige modellen. Ze hopen op een doorbraak, die iets oplevert dat wel winstgevend kan zijn - maar om tot die doorbraak te komen moeten ze lang genoeg blijven bestaan, en of die ooit komt is nog heel onzeker.

"AGI" zou zo'n mogelijke doorbraak kunnen zijn.
Die website wordt inderdaad vaak rondgeslingerd om dat soort argumenten te ondersteunen. Het feit blijft dat AI de wereld aan het veranderen is, maar helaas zien veel mensen en bedrijven dat nog niet.
"Jullie zien het niet" is ook zo'n inhoudsloze opmerking waar het zelotenleger zich te pas en onpas van bedient.
Het is inderdaad heel vermoeiend om hetzelfde verhaal te blijven herhalen aan mensen die onvoldoende kennis hebben van de materie, maar er wel graag iets van willen vinden. Zoals ik al vaker heb geschreven hier: ik kan het je uitleggen, maar ik kan het niet voor je begrijpen.

En het verbaast mij enorm dat een gemiddelde Tweaker ook de ontwikkelingen niet kan inschatten en koppelen aan verdere gebeurtenissen. Genoeg IT consultants die niet zo goed zijn in IT ;)
Je begrijpt blijkbaar niet hoe de verificatie werkt. In dit geval heeft het "tweede AI model" (nee, nog steeds GPT6) de Lean verificatie opgesteld. Maar om die Lean verificatie vervolgens uit te voeren gebruik je een klassiek computerprogramma.
Ik denk dat hij refereert naar dit stukje uit het artikel:
Daarna werd de informatie nog geverifieerd, wat 17 uur en 130 miljard outputtokens kostte.
Er staat niet specifiek dat het door "andere" AI modellen is geverifieerd, maar wel dat het doormiddel van een AI model is geverifieerd.
Nee, hoor.

Ria Matsijs heeft het Godsbewijs van Van Baalen correct bewezen. Ze heeft LLMs gebruikt bij het schrijven van het bewijs - maar Coq heeft het bewijs vervolgens gecontroleerd.

Laat die eerste ploeg agents Van Baalen zijn, en die tweede ploeg Ria plus die LLMs, dan is de analogie compleet.
Ik ben vooral benieuwd of dit door de wetenschappelijke ballotage van peer review heen komt en wat andere wetenschappers van de oplossing vinden.
Dat zou wel eens lastig kunnen worden. Het probleem met veel computerbewijzen is dat ze zo lang zijn dat geen mens ze ooit kan controleren. Als je het uberhaupt al de tijd hebt om het allemaal te lezen is het maar de vraag of je fouten kan vinden in een berekening van duizenden pagina's, terwijl je als mens zeker zelf fouten gaat maken tijdens het controleren.
Nu kun je controles voor een deel ook door de computer laten doen, maar dat vereist weer een extra laag die je ook weer moet controleren en vertrouwen.
Ze hebben in drie dagen tijd een keurige 166 pagina's tellende paper geschreven met daarin een sluitend wiskundig bewijs. Het originele bewijs voor de laatste stelling van Fermat omsloot ook meer dan 100 pagina's.
Ze hebben in drie dagen tijd een keurige 166 pagina's tellende paper geschreven met daarin een sluitend wiskundig bewijs.
tnx voor de link,


Oh, slechts 166 pagina's zware wiskunde, en zelfs wat minder als je de inleiding weglaat ... ;) Het is inderdaad een andere orde van grote dan de "duizenden pagina's" waar ik het over had maar het blijft een flinke lap.

Als je dat in drie dagen weet op te schrijven kan er niet veel tijd voor controle zijn geweest. Ik neem aan dat het meeste schrijfwerk ook door een LLM is gedaan, er staan in ieder geval geen namen van auteurs bij. Het controleren zal zeker meer dan drie dagen gaan kosten.

Of het een sluitend bewijs is moeten we dus nog maar zien. Ik heb geen reden om te twijfelen hoor, maar geen mens kan honderd pagina's schrijven of controleren zonder een fout te maken.
Het originele bewijs voor de laatste stelling van Fermat omsloot ook meer dan 100 pagina's.
Dat bewijs is eerst een keer gepubliceerd met een fout er in die pas een jaar later ontdekt werd. Uiteindelijk bleek het achterliggende idee gelukkig te kloppen, maar bewijzen dat een bewijs klopt kan een flinke klus zijn.

Ergens is het een tikkie oncomfortabel dat er bewijs is dat niet zo duidelijk is dat iedere leek in één oogopslag kan zien dat het klopt, maar dat is nu eenmaal wel vaker zo. Is het wel echt "bewijs" als je kan discussieren over de juiste uitleg en interpretatie? Maar daarmee komen we terecht bij wetenschapsfilosofie.

Enniewee, ik denk dat het nog wel een jaar gaat duren voor we hier echt op kunnen vertrouwen, maar dat heeft verder niks met AI te maken maar alleen meet de lengte van het bewijs.
Op zich leveren ze het bewijs ook in de vorm van een 'Lean script'. Dat is een soort van programmeertaal voor het formaliseren van wiskundige bewijzen, zodat ook een computer ze kan controleren. Als een dergelijk script een bevestigend antwoord geeft, dan geeft dat alweer iets meer vertrouwen in de validiteit van het resultaat.
Ergens is het een tikkie oncomfortabel dat er bewijs is dat niet zo duidelijk is dat iedere leek in één oogopslag kan zien dat het klopt, maar dat is nu eenmaal wel vaker zo.
Dat is natuurlijk al gauw zo met wiskunde. 'Iedereen' weet dat optelling commutatief is, i.e. a+b=b+a. Toch zullen enkel mensen met een behoorlijke portie affiniteit met wiskunde het formele bewijs ervan goed begrijpen.
Ja, idd. Zo schijnt het bewijs voor de laatste stelling van Fermat ook heel moeilijk te volgen te zijn.
Of topic:
Ik las eens over de stelling die zegt dat een getal maar op één unieke manier in priemgetallen te ontbinden is. In eerste instantie dacht ik, dat is toch vanzelfsprekend. Totdat je probeert een bewijs te formuleren, dan blijkt het ineens helemaal niet zo vanzelfsprekend te zijn.
Als je niet specificeert in welke algebraïsche structuur je aan het werken bent, dan klopt dat ook gewoon niet. :P
Klopt, bij zwevendekommagetallen met eindige precisie is het bijvoorbeeld ook gewoon niet waar. Maar dat gaat voorbij het punt dat ik wilde maken.
Een geformaliseerd bewijs is prima automatisch te controleren tegenwoordig. Dat is niet "voor een deel", dat is 99.9%.

Het allerbelangrijkste wat je nog met de hand moet controleren is wat er eigenlijk bewezen is. In dit geval staat het gekend als "Navier Stokes variant C" maar dat is een onduidelijke benaming. Je moet checken of de input van het automatische bewijs precies die Navier Stokes variant is.
gekend als "Navier Stokes variant C"
De variant die in het vraagstuk wordt beschouwd is gekend als de incompressibele variant, die enkel geschikt is voor lage stroomsnelheden, ten opzichte van de geluidsnelheid van het betreffende medium.

Het vraagstuk zelf is in beginsel generiek opgesteld. Om potentiële oplossers van het vraagstuk een handreiking te doen zijn er vier iets specifiekere varianten van het generieke probleem geformuleerd, waarvoor het aantonen van één van de varianten volstaat voor toekenning van de prijs. In dit geval is OpenAI er in geslaagd om variant C (en D) van de probleemstelling aan te tonen.
Jeetje wat een een zure reacties hier. Er is een groot wiskundig probleem is opgelost, dit is wat ik wil lezen als een artikel over AI gaat!
Omdat het erop lijkt dat AI niets heeft opgelost, maar het werk van 2 mensen gejat heeft en daarna het naar het einde gebrute-forced heeft.

Dat is ook veel van de huidige kritiek op AI, in hoeverre is het echt AI en niet een gigantische database/'encyclopedie'/supercomputer.
De kern van de oplossing is niet gestolen. Want totaal anders. Ervan uitgaande dat de oplossing correct is, wat nog moet bevestigd worden.
OpenAI claimt een unforced Euler-resultaat, terwijl Buckmaster en Alpöge forced Euler publiceren.
OpenAI
Volgens mij vallen die reacties wel mee. Vragen wat het de maatschappij gekost heeft, zijn niet onterecht, ondanks dat het oplossen van het wetenschappelijke probleem natuurlijk een mijlpaal zou zijn.

Als je echter leest dat er een grote kans is dat er leentjebuur gespeeld is met informatie die een menselijke wetenschapper heeft aangedragen , dan is het toch een vreemde gewaarwording om te horen dat AI het heeft opgelost.

Persoonlijk zou het me gezien de Hugging Face berichtgeving niet verbazen als later duidelijk wordt dat AI agents niet alleen gebruik hebben gemaakt van geanonimiseerde data van wetenschappers, maar gewoon besloten hebben om de informatie direct bij de bron te hacken.

Mensen hebben een onveilig gevoel bij AI onder andere omdat niet duidelijk is welke informatie van jou is en blijft. Berichten zoals deze, waarbij het onderzoek, welke gezien kan worden als een piek van menselijk intelligent vermogen, door AI opgeslokt wordt en toegeschreven wordt aan een "machine" helpt dan niet echt.
Vragen wat het de maatschappij gekost heeft, zijn niet onterecht
Tuurlijk wel, er zijn mensen die hier hun geld aan willen verspillen. Dat 'jij' het misschien niet interessant vindt wil niets zeggen, 'ik' vraag me dan bv af wat Formule 1 wel niet voor geldverkwanseling is, is ook nergens voor nodig..

(Ps, jij en ik zijn tussen haakjes omdat het dus niet persoonlijk bedoelt is, maar puur als voorbeeld).
Waarom is de vraag stellen niet terecht? Mensen kunnen pas een afweging maken of iets de moeite waard is wanneer ze weten wat het opbrengt en wat het kost. Nu zie je wat het opbrengt, maar niet kost, omdat die informatie niet aan de grote klok gehangen wordt.

Een goed werkende democratie vereist dat kiezers goed geinformeerd zijn. Alleen de baten presenteren zorgt ervoor dat mensen niet volledig geinformeerd zijn. Dat staat los van gevolgtrekking.

Wat het kost, kun je puur in het financiele trekken, maar zoals meerdere tweakers al hebben opgemerkt, er zijn ook ecologische kosten aan die de maatschappij als geheel raken. Gezien negatieve ervaringen met eenzijdige berichtgeving in het verleden, is het niet onterecht om kritisch te zijn.

Het mooie van vragen stellen is dat antwoorden daarop soms ook geruststellend kunnen zijn of dat je andere afwegingen kunt maken. Dan kom je er bijvoorbeeld achter dat de maximale hoeveelheid CO2 die uitgestoot werd rond de 500 ton CO2 ligt, ongeveer gelijk aan 2500 Europese vluchten, wat minder dan 10% is van de hoeveelheid dagelijkse Europese vluchten of dat het een fractie is van de uitstoot van 1 cruiseship dat een week uitvaart.
Er is een groot wiskundig probleem is opgelost
Laat het OpenAI dan eerst ook echt aantonen. Tot nu toe zie ik vooral een blogpost dat ingaat op de gebruikte techniek, maar nagenoeg niks over de oplossing zegt (het hoofdstuk "The Result" blijft in erg vage termen).

Er zijn eerder wetenschappers met baanbrekende oplossingen naar buiten getreden (o.a. P=NP komt om de zoveel tijd wel eens voorbij), waar door anderen vervolgens fouten in gevonden zijn. Dat soort claims komt met meer onderbouwing dan deze blogpost.

Maar goed, OpenAI's doel is ook duidelijk. Dat vertellen ze zelf namelijk:
Our goal in releasing this result is to report on the substantial progress of our AI models.
Kortom: het doel is marketing - vertellen over hoe goed ze het doen. De wetenschap hierachter is bijzaak, en in deze claim eigenlijk zelfs volledig achterwege gelaten.
De specifieke belangrijke claim hier is "Lean". Voor de niet-wiskundigen hier: dat is een manier om je resultaat expliciet en gedetailleerd op te schrijven zodat het met een computer (niet AI) gecontroleerd kan worden.

Dat heeft OpenAI dus sowieso gedaan, en dat is een concrete bijdrage die sowieso telt. De vraag is nog wel hoeveel ze hiervoor eigenlijk aan eigen werk hebben gedaan.
I stand corrected. De links naar het paper en de lean repo had ik vanochtend over het hoofd gezien - dat is dan inderdaad wel concreet.
De goal is natuurlijk zoveel mogelijk nieuws, positief of niet vlak voor de IPO. Kijk wat ChatGPT kan.

Ergens mag tweakers van mij best wel met dit soort onzin bedrijven daar harder op ingaan, puur een buitenlandse fut berichtje vertalen voegt weinig toe. Maar een stukje context en onderzoek kan geen kwaad zeker bij dit soort bedrijven.
Oprechte vraag: maar wat schiet de samenleving ermee op als dit probleem werkelijk opgelost zou zijn? Is het iets wat ons verder helpt op een praktisch vlak, of is het puur theoretisch?

[edit] Voor de downvoters, ik was alleen nieuwsgierig naar de praktische toepassing hiervan, dit is ver buiten mijn kennisgebied dus ik wist het gewoon niet en het Wiki-artikel dat gelinkt werd gaat mij dus ook mijn pet te boven :D Dank voor de Jip en Janneke uitleg @SuperDre, die snap ik wel :D

[Reactie gewijzigd door mvds op 9 september 2026 11:31]

Hiermee kunnen oa weersmodellen verbeterd worden waardoor bv voorspellingen accurater worden en dus ook early warning systemen verbeteren wat levens en materieele schade kan beperken. Maar das zoals ik het begrepen heb. Blijkbaar is het een bijzonder probleem, anders zou het niet op die lijst van onopgeloste wiskundige problemen hebben gestaan.

Tja, sommige vinden dit dan onzin en geldverspilling, maar is dan bv Formule 1 racen of een tour de france ook niet onzin en pure geldverspilling?
Volgens mij gaat het hier om een stelling waarvan we niet zeker zijn of deze altijd waar is. Dit probleem zou nu opgelost zijn. Dus A: er is bewezen dat het altijd waar is. Of B: er is een geval gevonden wanneer het niet waar is.

Neem de stelling van pythagoras. Deze is al lang bewezen, al denk ik dat er weinig mensen zijn die het bewijs kennen of kunnen. Toch ga ik er vanuit dat bijna iedereen deze stelling wel eens gebruikt heeft.

Stel nou eens dat we niet zeker zijn dat de stelling van pythagoras juist is. Dan zou alles waar we deze stelling gebruiken, mogelijk ook niet juist zijn.
al denk ik dat er weinig mensen zijn die het bewijs kennen of kunnen
Op zijn minst iedereen die wiskunde op de middelbaarschool heeft gehad toch?

Edit: Ja sorry je neem zo maar een voorbeeld, ik snap wat je bedoel, maar vind het ongelukkig.

En inderdaad, de stelling was gebruikte voor dat pythagora het bewijsde, zoals een pudding dus.

[Reactie gewijzigd door moimeme op 9 september 2026 17:51]

Er zijn hier veel mensen bang dat ze straks geen werk meer hebben omdat hun werk steeds minder waard wordt. Dan maar zo veel mogelijk mopperen op AI. Helpt niets maar lucht wel op.
Toch wel opmerkelijk: Claimen dat je iets gewonnen hebt maar niet kunnen uitsluiten dat je vals heb gespeeld.
Valsspelen door antwoorden elders proberen te vinden is nogal lastig voor een probleem wat nog niemand heeft opgelost. :+
Dan raad ik je aan om even het verhaal te lezen: https://cims.nyu.edu/~tristanb/statement.pdf

Daarin komt naar voren:
- OpenAI koos een oplossingsrichting die wel erg overeen kwam met die van een onderzoekers die het geheim hielden
- Er werden vergelijkbare termen gebruikt die onderzoekers zelf bedacht hadden
- Toen OpenAI daarmee geconfronteerd werd was het voorstel dat de onderzoekers eerst hun verslag uit zouden brengen, en een dag later zou OpenAI dat doen (huh... wat zouden ze in een dag tijd kunnen doen?)
- Toen dat voorstel geweigerd werd en de onderzoekers aangaf dat ze openheid van zaken zouden geven werd hun gevraagd: "Why would you ruin your career?". Wat in mijn oren wel heel fout over kwam.
- Oh, en het bleek dat de instructies bij OpenAI telkens door mensen werd bijgewerkt. Het is dus niet het pure "AGI" geweest.

OpenAI had heel simpel kunnen claimen dat ze geen misbruik gemaakt hebben, maar het feit dat ze dat niet doen (zelfs geen poging) is voor mij een indicatie dat ze het zelf ook niet 100% vertrouwen.

Want als niemand het probleem nog niet opgelost heeft dan moet het toch vrij simpel te zijn om die claim te maken, of niet soms?
Je vergeet te melden dat OpenAI de eis had dat de tweede onderzoeker uit het onderzoek geschrapt moest worden (omdat die voor Anthropic werkt).
Ah kijk, dat is het stukje nuance dat ik miste op basis van de eerdere post en het artikel. Maar dank voor de toevoeging!
Het enige dat dan ontbreekt is een bronverwijzing naar een (deel)oplossing?
Nou ja, vaak kun je een probleem opdelen in kleinere deelproblemen. Als enkele daarvan al opgelost waren, en dat krijg je 'toevallig onder ogen', dan kun je dat wel gebruiken.
Uit openbaar gemaakte e-mails blijkt echter dat OpenAI op de hoogte was van de voortgang van de twee wiskundigen. Het is onduidelijk of het bedrijf ook daadwerkelijk toegang had tot inhoudelijke informatie die tot de uiteindelijke oplossing leidde.
Tsja, zelfs Darwin werd hevig geïnspireerd door en zelfs bijna vooruitgestreefd door Wallace.

Zoiets kun je nu eenmaal niet alleen. Eerlijk dat OpenAi het toegeeft.
De relatie tussen Darwin en Wallace was compleet anders dan die tussen OpenAI en Buckmaster. Wallace en Darwin hebben samengewerkt en elkaars stukken gelezen. OpenAI beweert iets origineels te hebben gedaan maar tegelijkertijd wilt het niet ontkennen dat het wetenschappelijk plagiaat heeft gepleegd.
"Hoewel het onwaarschijnlijk is, kunnen we niet uitsluiten dat anonieme data uit het gebruik van onze producten gebruikt werd om onze modellen te verbeteren."

Dit is wel wat meer dan inspiratie. Dit is de geheime aantekeningen van de concurentie jatten en er dan met de eer vandoor gaan.
Jamaar, jamaar, dat was per ongeluk.
Tja, en die onderzoekers gebruiken ook het AI systeem wat weer getraind is op vragen en probleemstellingen van anderen, dus dan stel je dat die ook al valsspeelden...
10.000 agents in 88 uur
Dus eigenlijk 88 x 10.000 = 880.000 uur?
32,25 miljoen dollar aan tokens (uitrekenen + verificatie)

Zo alles bij elkaar vind ik het dan niet spectaculair klinken.
Hoeveel energie is er verstookt? Iemand daar een accuraat beeld bij?
edit:
Bij een 40-urige werkweek, en 48 volledige werkweken werkt één iemand 1920 uur in een jaar.
880.000 uur is dan het aantal uur van 458 arbeidsjaren.

[Reactie gewijzigd door Piemol op 9 september 2026 11:41]

Zeer goede vraag. Wellicht is dit het grootste probleem van AI, als iedereen zijn/haar "belangrijke" problemen opgelost wil krijgen dan mogen we vaarwel zeggen aan het beperken van de opwarming van de aarde. Een enorm belangenconflict en gezien mensen meestal voor de korte termijn kiezen kan AI wel eens het strohalm zijn dat de rug van de kameel breekt.

Begrijp mij niet verkeerd, ik vind het werkelijk fantastisch dat complexe problemen waarvoor wij onvoldoende hersenkracht hebben opgelost gaan geraken, maar er is zoveel op te lossen en te verbeteren dat het nog maar de vraag of fossiele brandstoffen gaan gestopt zijn alvorens al het ijs op de wereld gesmolten is en de zeespiegel tientallen meters hoger ligt.
Of, out of the box denkend, je gebruikt AI om een oplossing voor het klimaatrprobleem te bedenken.
Er zijn genoeg manieren waarvan we al lang weten dat we de klimaatproblemen kunnen beperken. Het probleem is dat de mensen die de macht hebben daar niets om geven of niet durven door te pakken.
Maar er zullen ook manieren zijn die we nog niet kennen (en mogelijk minder afhankelijk zijn van de mensheid). Denk aan chemische processen die we nu nog niet kunnen berekenenen/kennen die kostentechnisch interessant gebruikt zouden kunnen worden om broeikasgassen te "wassen"/om te zetten naar een niet schadelijke of zelfs nuttige stof.
Grootste probleem is de grote lekkages van methaan buiten europa die onze satalieten al jaren opsporen. Een (onze heilige) koetje meer of minder electrisch gaat het klimaat probleem echt niet oplossen...

https://www.science.org/doi/10.1126/sciadv.abn9683

Eén zo'n vuilnisbelt (landfill) stoot het equevalent van een half million auto's uit _per uur_!

Bron: https://www.sron.nl/en/ac...n-honderdduizenden-autos/
Dit is erg belangrijk en krijgt veel te weinig aandacht.

Dit is erg belangrijk en krijgt veel te weinig aandacht.

Dit is erg belangrijk en krijgt veel te weinig aandacht.

Zou de zin 3 keer plaatsen helpen? ;-)
Deze manier van denken - het wachten op een technologische oplossing - is gevaarlijk omdat het afleid van de bewezen hoofdveroorzaker van de huidige klimaatellende.
En deze manier van denken heeft al meer dan vijftig jaren lang bewezen dat het niet werkte.
Dat is de zwarte humor van het klimaatprobleem, de oplossing is niet echt heel moeilijk. We vinden de oplossing gewoon "niet leuk".
De oplossingen zijn al lang bekend. Kapitalisme en menselijke egoisme staat in de weg, helaas. Dat probleem valt niet op te lossen, vrees ik, waar dankzij het kapitalisme ook de rijken de macht hebben.
Kapitalisme blijkt in de geschiedenis steeds het beste economische systeem die de meeste welvaart en kansen bracht. Ook voor de armsten. Toch menen sommigen dat het de bron van alle kwaad is.
Dat gold ten tijde van het feodale systeem ook voor dat systeem. Daar denken we nu anders over.
Vertel mij wat er dan mis is met het kapitalisme: het optimaal inzetten van kapitaal, arbeid en kennis in een vrije markteconomie. Afgekaderd door wetgeving en reguleringsinstanties die monopolies en kartels voorkomen en zorgen dat de marktmacht van aanbieders en afnemers in evenwicht blijven.
Wat is het alternatief? Een overheid die alles stuurt? Want ambtenaren weten het per definitie beter en werken sneller en effectiever?
Dit zou kunnen helpen, maar dan moet er een prijskaartje gehangen worden aan allerlei vormen van roofbouw/vervuiling/etc.
Ook moet je zeggen: "Dit stuk natuur (oerwoud, bosje, riviertje, etc) is X euro waard".

Dit is al meer dan 20 jaar geleden voorgesteld, maar niemand krijgt het mondiaal van de grond (om de bekende redenen).

Doe je dit niet, dan blijft kapitalisme alleen de motor opvoeren om sneller en meer roofbouw te plegen.
Ik ben ook niet per-definitie tegen kapitalisme, het is inderdaad veruit het beste systeem in principe. Maar de manier waarop het nu wereldwijd tot uiting komt met de gigantische kloof tussen arm en rijk en de manier waarop de rijken invloed hebben op politieke beslissingen (en dat is van alle tijden, weet ik) zorgt ervoor dat we dit soort grote problemen zoals klimaatverandering nauwelijks zullen kunnen oplossen.

De mensen met de macht om de kloof te verkleinen en het klimaat te verbeteren verdienen nu geld aan de vervuiling van de planeet en uitbuiting van de armen. Ik zie niet hoe we dat kunnen gaan oplossen zonder een gigantische ommezwaai en revolutie.
Tenzij je een manier vindt die minder afhankelijk is van kapitalisme en egoisme.
Er zijn nog geen adequate technische oplossingen. Jij refereert misschien naar de stompzinnige degrowth ideeën die vaak aangedragen worden, maar die zijn totaal onrealistisch en potentieel veel gevaarlijker dan klimaatverandering.

We zullen ons een weg eruit innoveren, zoals altijd.
Het helpt ook niet mee dat de "AI"-grootmachten (de VS en China) niet direct het gevaar van klimaatverandering zien en of willen erkennen. Dan kunnen wij in de EU wel de braafste leerling van de klas willen zijn, maar als de andere grote economieën niet meewerken dan is het effect onvoldoende.

Maar ja dan geldt natuurlijk ook de vraag wie heeft er nog geen gebruik gemaakt van een "AI"-oplossing? We doen er natuurlijk zelf net zo hard aan mee.

Aan de andere kant zal er waarschijnlijk ook wel een keer een eind komen aan het maar blijven investeren in dit soort bedrijven, er moet op een gegeven moment ook winst gemaakt gaan worden - hopelijk dat dit dan zorgt voor een gezondere manier van bedrijfsvoering (wat dan hopelijk ook zorgt dat de energieverspilling onder de loep genomen gaat worden...)
China is in rap tempo aan het verduurzamen, dus wat dat betreft is het echt alleen de VS.

En er zijn nog steeds genoeg mensen die geen AI gebruiken omdat het gewoonweg niet ethisch verantwoord is.
Dat is goed nieuws. Houden zo!
Begrijp mij niet verkeerd, ik vind het werkelijk fantastisch dat complexe problemen waarvoor wij onvoldoende hersenkracht hebben opgelost gaan geraken, maar er is zoveel op te lossen en te verbeteren dat het nog maar de vraag of fossiele brandstoffen gaan gestopt zijn alvorens al het ijs op de wereld gesmolten is en de zeespiegel tientallen meters hoger ligt.
Lijkt er sterk op dat :
  1. We voldoende "hersenkracht hadden"
  2. AI niet echt iets "oplost" het maakt "papier" werk voornamelijk "sneller". (!= efficienter)
Ik vind het geweldig, maar ik hoop dat we snel een AI krijgen die een pak efficienter kan draaien. Een ChatGPT op m'n mobieltje.
Het zal nooit voldoende zijn zolang de wereld niet "perfect" is, onze hersenkracht en ook de rekenkracht mogen nog veel meer worden.

Of AI nog efficiënter kan op softwarematige basis zonder in te leveren aan kwaliteit dat weet ik niet, chips zullen wel nog blijven efficiënter worden alhoewel dit steeds langzamer wordt.

De komende jaren zou de bottleneck verschuiven van DRAM chips naar energie dus een efficiëntere AI dringt zich wel op want we gaan sowieso nog enorm veel meer AI gaan inzetten. Denk maar eens hoeveel mensen nog langzaam aan bezig zijn om te mogelijkheden te ontdekken.
Maakt het uit? Wat denk je dat al die 'professoren' tot nu toe gekost hebben die ooit met dit probleem bezig zijn geweest? En wat maakt het uit wat het gekost heeft, ten opzichte wat de oplossing voor uiteindelijke besparing kan opleveren, is het een fractie.
Ik vind dat er wel wat verschil zit tussen twee uitspraken:
  1. Ik heb dit in 88 uur opgelost
  2. Ik heb dit met mijn team van 10.000 man in 88 uur opgelost
Nu is de headline 'binnen 88 uur'.
Maar het is toch ook in 88 uur opgelost.. of denk je dat een doorsnee professor ook de uren van zijn medewerkers meetelt? Nee dus, er wordt gekeken naar wanneer ze gestart zijn, en wanneer ze de oplossing hadden. En er wordt gewoon netjes aangegeven hoeveel agents ze er voor nodig hadden.
Het kost OpenAI zelf natuurlijk geen tokens, het kost OpenAI stroom en misschien 88u aan afschrijving op de hardware.

En het is natuurlijk wel indrukwekkende dat LLM modellen die twee jaar geleden fouten maakten in simpele rekensommen nu ingewikkelde wiskundige problemen zelfstandig oplossen.
Die tokens hadden ze anders kunnen verkopen, is natuurlijk niet exact hetzelfde, maar resources kun je niet twee keer uitgeven. Het aantal tokens geeft een soort van orde van grootte aan.
Redelijk wat geld om uiteindelijk iets op te lossen wat ze van een van hun eigen gebruikers gestolen hebben :+
[...]

Zo alles bij elkaar vind ik het dan niet spectaculair klinken.
Elk tot nu toe onoplosbaar geacht probleem wat nu ineens toch opgelost wordt is in mijn ogen spectaculair, of ik er u de impact van begrijp of niet.

We konden het niet, en nu wel. Mooi toch?
'openai claimt', geen peer reviews? Geen onafhankelijke natuurkundigen om te beoordelen of deze oplossing ergens op slaat?

Ik geloof het pas als de stichting achter de millenium problems daadwerkelijk het miljoen heeft overgemaakt.
Nou ja, zo gaat dat toch? Kan nog maanden aan checken en heen-en-weervragen duren voor het daadwerkelijk door de gemeenschap wordt geaccepteerd.
Of afgewezen, AI hallicuneert, maakt fouten, het is zeker plausibel dat dit geen goede oplossing is. en vooral de controlerende ai om de tuin geleid is.

Dus het is niet gedaan tot dat het geverifieerd is.
OpenAI zegt dat ze het bewijs ook hebben geformaliseerd in Lean. Op dat punt valt er weinig "om de tuin te leiden".

Je kan de uitspraak van de stelling (geformuleerd in Lean) makkelijk verifiëren als mens, en Lean4 is een betrouwbare manier om te checken of de redenering inderdaad tot bewijs van deze stelling leidt.
en tegen de tijd dat het eindelijk gecontroleerd is en ze erachter komen dat het dus niet klopt is iedereen het allang weer vergeten en met wat geluk komt er een kort artikeltje voorbij waarin dit wordt uitgelegd en blijft iedereen denken dat OpenAI de oplossing hiervoor heeft gevonden.

en zelfs als het wel blijft hangen dat het toch niet klopt hebben ze twee keer gratis reclame voor de claim.
Benieuwd als dit gevalideerd wordt en de beloofde premie wordt uitgekeerd, OpenAI nog bestaat als bedrijf.
Hoezo dat nu? Sowieso weet je dat de AI die jij gebruikt door blijft leren op basis van vragen en probleemstellingen die je em voorlegt. Denk je overigens niet dat die wiskundigen ook hun oplossing bedacht hebgen zonder gebruik van informatie die door anderen in het systeem terecht zijn gekomen of dus informatisle die ze zelf ergens gelezen hebben?
dus niet kleverig
smoothness heeft niets met kleverigheid te maken, maar met differentieerbaarheid van de vergelijkingen in wiskundige zin. Een vergelijking waarin een singulariteit optreedt is aldaar niet differentieerbaar.
Klopt, die zin was onjuist en verwarrend. Ik heb 'm uit de beschrijving gehaald!

Om te kunnen reageren moet je ingelogd zijn