Framework vraagt 7659 euro voor Desktop met 192GB ram en zonder ssd

Framework komt met een nieuwe variant van zijn Desktop-mini-pc. Die krijgt een nieuwe Ryzen AI Max+ PRO 495-processor met 192GB geïntegreerd geheugen. Een diy-versie zonder ssd kost 7659 euro. Een kant-en-klare versie met 2TB opslagruimte en Fedora Linux kost 8379 euro.

Dit nieuws in het kort

  • Framework komt met een specbump van zijn Framework Desktop-pc.
  • Die heeft 64GB meer en iets sneller geheugen, naast een iets hoger geklokte cpu en gpu.
  • Het apparaat kost minstens 7659 euro en is daarmee bijna twee keer zo duur als zijn voorganger.

De nieuwe Framework Desktop-variant is vanaf nu vooruit te bestellen, schrijft de fabrikant in een blogpost. Framework verwacht de compacte pc vanaf november te leveren, al gaat dat om een relatief kleine batch.

Er komen later wel nieuwe batches, maar de verkoopprijzen en leverdata daarvan hangen af van de geheugenprijzen.

Framework Desktop 192GB
De Framework Desktop is nu leverbaar met 192GB.

Kleine update met meer ram

Bij deze kleine update heeft Framework alleen de processor vernieuwd. De Ryzen AI Max+ PRO 495 is namelijk een licht aangepaste versie van de voorgaande Max+ 395.

De nieuwe chip biedt vergelijkbare specificaties, maar ondersteunt tot 192GB Lpddr5X-geheugen in plaats van maximaal 128GB. Net als bij de voorgaande Framework Desktop is dat geheugen niet te upgraden. Verder zijn de cpu en gpu iets hoger geklokt en draait het geheugen op een iets hogere snelheid.

Verder heeft de Framework Desktop dus nog steeds zestien Zen 5-cpu-cores en een ingebouwde RDNA 3.5-gpu met veertig compute-units. De behuizing en aansluitingen zijn ook gelijk aan die van de bestaande Framework Desktop, die vorig jaar verscheen.
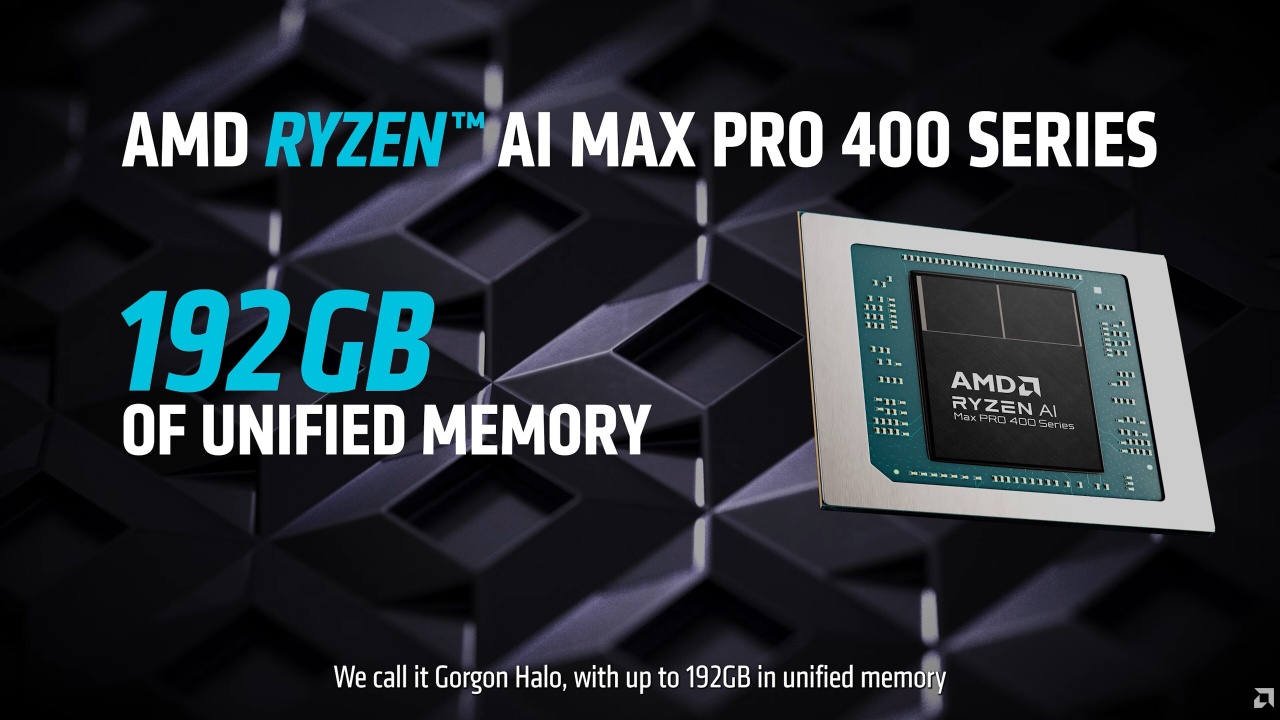
AMD Ryzen AI Max PRO 400
De nieuwe Ryzen AI Max PRO 400-serie ondersteunt tot 192GB ram. Beeld: AMD

Twee varianten

Framework levert twee versies van de vernieuwde Desktop. Een diy-versie zonder meegeleverde M.2-ssd kost 7659 euro. Gebruikers moeten bij die variant ook een eigen besturingssysteem installeren.

De kant-en-klare variant wordt standaard geleverd met een 2TB-ssd. De fabrikant installeert Fedora 44 KDE op diezelfde ssd. Een versie met Windows is niet beschikbaar. Gebruikers die liever dat OS willen draaien, moeten daarvoor dus zelf een licentie kopen. Deze versie kost 8379 euro.

De 'oude' Framework Desktop blijft ook gewoon beschikbaar als diy-editie. De duurste variant daarvan met Ryzen AI Max+ 395 en 128GB ram kost 3889 euro, weer exclusief ssd. Het nieuwe model kost dus bijna twee keer zoveel, en krijgt daarvoor 64GB extra ram, een hogere geheugensnelheid en een 100MHz hogere kloksnelheid voor de cpu en gpu.

Nieuwe Framework Desktop vergeleken met de oude
Desktop Framework Desktop (nieuw) Framework Desktop (oud)
Processor Ryzen AI Max+ PRO 495 Max. Ryzen AI Max+ 395
Cores/Threads 16C/32T (Zen 5) Max. 16C/32T (Zen 5)
Kloksnelheid Base: 3,1GHz
Boost: 5,2GHz
Base: 3,0GHz
Boost: 5,1GHz
Geheugen 192GB Lpddr5X-8533 Max. 128GB Lpddr5X-8000
Gpu RDNA 3.5, 40 CU's, 3,0GHz RDNA 3.5, 40 CU's, 2,9GHz
Prijs Diy: 7659 euro
Prebuilt: 8379 euro
Diy (128GB-model): 3889 euro
Prebuilt: n.v.t.

Door Daan van Monsjou

Nieuwsredacteur

01-10-2026 • 13:54

64

Reacties (64)

Sorteer op:

Weergave:

oef dat is wel een groot verschil qua prijs voor een Spec bump naar de 495+ en 64GB RAM meer wel 8533Mhz t.o.v. 8000Mhz geheugen.

Iemand die echt bezig is met local AI -> verdien je het prijs verschil eenvoudig / binnen afzienbare tijd terug?
Je verdient het nooit 'terug' als je like for like gaat vergelijken, ook niet met het goedkopere model.

In 128GB kan je een model kwijt wat je ook standaard krijgt bij een ChatGPT abo van €23/maand, met een machine van €3389 kan je dus 14 jaar een ChatGPT abo nemen. Dan hebben we het niet eens over de stroom die die machine verbruikt en eventuele koeling in de zomer. Met andere woorden, er is geen break even moment. Met een machine van €7659 kan je bijna 28 jaar aan de Chat GPT of 7 jaar met een duurder €103/maand abo.

In beide gevallen heb je toegang tot VEEL betere modellen die ook nog eens veel sneller zijn. De kans is zelfs aanwezig dat als je GPU capaciteit gaat huren je nog steeds goedkoper uitbent dan als je het zelf gaat kopen/draaien.

De enige reden dat je dit doet is omdat je zelf ermee wil knutselen/ontwikkelen OF dat je met data werkt die niet een andere dienst in mag. Echter is dan de kans ook groot dat het ook al niet op jou lokale PC verwerkt mag worden op een lokaal model...
bij een ChatGPT abo van €23/maand, met een machine van €3389 kan je dus 14 jaar een ChatGPT abo nemen.
Iemand die dat soort geld heeft te besteden, die zal geen genoegen nemen met het goedkoopste CheatGPT abonnement. Daarnaast zijn de mogelijkheden qua toegang tot de betere modellen en hoeveel tokens je daar te besteden hebt )per maand) nogal aan de karige kant.

Je zal dan eerder een 200 USD per maand abonnement bij zo'n persoon verwachten. en dan heb je na 42 maanden (3,5 jaar) al meer aan je abonnement uitgegeven dan aan de duurste variant van de Framework Desktop. Of ruim 1,5 jaar voor de goedkopere model.

Maar deze week werd verkondigd dat de mogelijkheden en tokens in dat 200 USD abonnement zijn gehalveerd en dat je nu 500 USD per maand af moet tikken voor deze voormalige mogelijkheden en tokens . Oftewel, dat duurste model is nu goedkoper dan 17 maanden (1,5 jaar) abonnement. Het goedkopere model is goedkoper dan 8 maanden abonnement.

Ja, de lokale modellen halen de kwaliteit niet van de cloud-modellen. En zijn ook trager. en je ziet het verbruik ook terug op je electriciteitsrekening. Dat is allemaal waar. Maar je hebt geen gezeur over limieten en privacy is beter en nu ik een tijdje heb zitten spelen met Qwen 3.8 27b op mijn eigen hardware, kan ik zeggen dat het model voor het meeste wat ik doe met AI (geen coding) niet zo heel veel verschilt van wat de cloud-modellen me voorschotelen.

Misschien was dat allemaal aan geluk te wijten, het is zeker mijn n=1 ervaring. En het heeft ervoor gezorgd dat ik nu meer met lokale AI wil gaan doen, zonder zorg dat andere bedrijven mijn gebruikersprofiel nog meer ten gelde kunnen maken dan dat zij nu al doen.

Dat is een afweging die iedereen. voor zichzelf zal moeten maken. Wat ik zeker weet is dat ik vrolijker word van lokale AI dan cloud-AI, sinds Qwen 3.8 is uitgekomen.
Hoewel Qwen prima is, kun je met een cloud AI wel sneller taken afronden en ook parallel dingen uitvoeren. Als je bv iets vraagt wat opgezocht moet worden, gaat via Qwen eigenlijk alles sequentieel. Het idee van agents leeft eigenlijk nog niet echt lokaal (vind ik) en er zijn nog niet hele simpele tools om dat goed te doen (vind ik). Het verschil is nog wel echt groot. Het gaat echt nog wel een jaar duren voordat de lokale modellen op het niveau zijn van de cloud modellen en dan net zoveel kunnen op nog acceptabele hardware (qua kosten). Maar ondertussen gaan die cloud modellen ook weer door. De enige reden waarom lokale modellen nog lekker bezig blijven, is omdat de prijzen anders te gortig worden. Maar momenteel is lokaal draaien eigenlijk nog niet echt goed te doen, daar heb je echt meer processors en meer bandbreedte nodig (lees: sneller geheugen en snellere GPU's). En die gaan straks ook weer de hoofdprijs kosten waardoor self-hosted zichzelf ook weer uit de markt prijst, tenzij je als bedrijf groot gaat inslaan en de kosten goed kunt opvangen. Voor consumenten vraag ik mij af hoe lang dat nog zo gaat lopen, want met de huidige consumentenhardware heb je gewoon teveel handicaps.
Het bedrijf waarvoor ik werk heeft een 500-tal personen in dienst. Er zijn 10 heftige AI gebruikers die zorgen voor een maandelijkse rekening tussen de 13k en 15k Euro. De reden ervoor maakt dat het ook wel waard. Het is echter ook een steeds terugkerend onderwerp bij meetings tussen de C-suits.

Over de tijdspanne tot nu toe is dat toch tot praktisch 500k Euro in totaal opgelopen. En dan vraag ik me toch af of een eigen server met een paar H100 GPUs niet goedkoper zou zijn geweest. Want dan kun je tenminste de betere open weight modellen uit China hosten voor de hele toko, welke amper onderdoen voor de frontier lab AI modellen.

Met vLLM kunnen er ook gewoon meerere personen er tegelijkertijd er gebruik van maken. En zoveel trager zou die server ook niet zijn in vergelijk met cloud-AI.
Mja voor veel bedrijven geldt dat momenteel wel. Het probleem is nu nog vooral het verkrijgen van de hardware denk ik. Want overal zitten lange wachttijden op en de kosten zijn enorm gestegen vanwege de bubbel. En opschalen gaat ook nog wel even duren.

Echter voor lokaal gebruik is het gewoon nog niet zo spannend. Ik heb hier een oudere Ryzen staan met 128GB, maar die is gewoon niet snel genoeg voor een beetje model, laat staan dat je er dan meerdere modellen tegelijk op kunt draaien om meerdere agents aan de slag te zetten. De ontwikkeling om normale hardware te gebruiken, duurt te lang en de beschikbaarheid van snellere hardware, plus de kosten ervan zorgen ervoor dat een lokale LLM die een beetje normaal werkt gewoon onhaalbaar is geworden.
Maar je gaat nu het rijden in een polo vergelijken (kopen) met het rijden in een ferrari (huren). Nogal wiedes dat je dan duurder uitkomt. Vergelijk like met like.
Goede vergelijking dan toch juist? Ik bezit liever een Polo die helemaal van mezelf is dan dat ik een Ferrari moet huren.
Ik huur liever een vrachtwagen dan dat ik een polo koop om een grote vracht te vervoeren.
Wat als je diezelfde Polo extreem goedkoop kan huren? Laten we zeggen voor 2/3e van de prijs van kopen, voor de levensduur van de auto...

En als die situatie veranderd je dan altijd nog een veel nieuwere Polo kan kopen voor dezelfde prijs, die tegen die tijd veel sneller en veel efficiënter is.

Tenzij ik hele specifieke eisen heb, dan huur ik liever dan dat ik koop.
Je zal dan eerder een 200 USD per maand abonnement bij zo'n persoon verwachten. en dan heb je na 42 maanden (3,5 jaar) al meer aan je abonnement uitgegeven dan aan de duurste variant van de Framework Desktop. Of ruim 1,5 jaar voor de goedkopere model.
Kan ik met dit framework ding ook 20+ agents tegelijk hebben draaien?
[...]

Kan ik met dit framework ding ook 20+ agents tegelijk hebben draaien?
Vast wel. Maar of er dan nog sprake is van snelheid, dat denk ik niet. Voor agenten is de bandbreedte van het geheugen van enorm groot belang. En daar blinkt ook deze nieuwe AMD AI chip niet in uit.

Bovenstaande is van minder groot belang als je de lokale AI voor chatting/prompting gebruikt.Voor zover ik heb begrepen het verwerken van je prompt op dit soort machines best rap, maar is het niet zo snel met het genereren van tokens waar jij op zit te wachten.

Bij Macs schijnt dat net andersom te zijn. Daar duurt het verwerken van prompts best lang, maar tokens worden wel een stuk sneller gegenereert.

Maar goed, dat is dus niet hetzelfde als agentic use. Ben zelf nu 'atomic-agent' aan het uitproberen. Ziet er op zich wel uit als een tool waarmee je toch wel een aantal agenten op zo'n nieuwe Framework Desktop "doos" redelijk kan laten draaien.
Vast wel. Maar of er dan nog sprake is van snelheid, dat denk ik niet.
Ik denk het eigenlijk niet want je moet dan iedere keer opnieuw de context van je andere conversatie inladen; lijkt me dus heel langzaam. Tenzij je meerdere sessies in het geheugen passen natuurlijk

[Reactie gewijzigd door Gamebuster op 2 oktober 2026 17:12]

Met het ChatGPT abo van 23 Euro per maand ben je binnen 3 dagen door je tokens als je een beetje doorploetert. Er is dus zeker wel een break-even moment want je gaat gewoon het 500 Euro abonnement nodig hebben om net zoveel gebruik te kunnen maken van ChatGPT als van je eigen lokale AI. Dan kom ik op 14-15 maanden, geen 14-15 jaar.

[Reactie gewijzigd door tv_nerd op 1 oktober 2026 15:00]

Met welk model doe je dat dan? En hoe snel denk je dat zo een Framework is die doet daar waarschijnlijk 30 dagen over...

Je kan op een 128GB versie een gpt oss 120b draaien, daar heb je geen zwaar ChatGPT model voor nodig om daar equivalent mee te draaien.
Hangt van het model af. Luna is bijvoorbeeld heel goedkoop op github copilot. Die kan je zeker 12 uur per dag aan het werk houden voor ~25 euro per maand. Een tier hoger kan je die bijna 24/7 bezighouden. Dat is een veel capabeler model (en veel sneller) dan alles wat je op die hardware kan draaien.
Mja Luna kan wel, maar ik merk wel grote verschillen tussen Luna en Sol of Astra. Meer dan bij de vorige iteraties van GPT. Vanaf 5.5 is eigenlijk het goedkoopste model niet echt meer aan te raden imo. Verspilt teveel tijd en tokens waar de rest echt significant sneller klaar is en met betere antwoorden komt. Helaas ben je dan dus inderdaad wel elke keer door je tokens heen. En waar je dan naar de 100pm kunt gaan, is het maar de vraag hoe lang dat nog toereikend is.
Hangt nog steeds heel erg veel af van welke taak je ze laat doen en hoeveel handvatten je ze geeft. Iets als een spring boot upgrade van een berg microframework modules in een super standaard oplossing met goede unit, integratie en end-to-end tests kan Luna prima (en snel) doen. Ja, een Sol of Sonnet is een stuk slimmer maar soms heb je gewoon niet een het slimste model nodig.
Met dat abonnement heb je een model die je niet zelf kan draaien. Noch iets wat ook maar in de buurt komt.
Na 14 of 17 jaar is de hardware waar die modellen op draaien al veel verbeterd, is lastig om te vergelijken met een eigen PC die je ondertussen niet upgrade in zo'n lange tijd?
Aan de andere kant worden modellen ook nog steeds efficiënter, dus wat je op minder krachtige hardware kan wordt waarschijnlijk ook nog beter in die tijd.

De vraag is wel of je hardware het überhaupt zo lang volhoudt..
Ze worden wel efficiënter, maar vooralsnog groeit het alleen maar en wordt het elke keer weer teniet gedaan door nieuwe benodigdheden om de modellen accurater en sneller te maken.
Er is specifiek voor dit platform nog heel veel winst te behalen, alleen al in de software die de LLM's serveert. Ja, de geheugenbanbreedte is laag, maar als je kijkt hoeveel snelheidswinst projecten als Halogen en Gufo weten te behalen ten opzichte van het meer doorsnee llama.cpp, dan zie ik de toekomst zonnig in. Een model als Qwen 3,8 Flash Next werkt al op redelijke snelheid en is vergelijkbaar in intelligentie met de Opus van een paar maanden geleden en het wordt alleen maar beter.
Mja het gaat langzaam, maar het komt er vast wel. Ik ben alleen bang dat de rest zoveel verder gaat waardoor het meer is alsof je een pentium 3 gebruikt terwijl er al een Nvidia 1080 op de markt is.

Ik probeer met mijn AMD 5600G en 128GB ram nog wel eens een model te draaien, maar het duurt vaak al meer dan een minuut om antwoord te krijgen op de vraag wat het weer hier is en daardoor is het gewoon niet bruikbaar voor normaal werk. En kleinere modellen zijn vaak niet in staat om uit te vinden hoe ze online moeten zoeken e.d. (of kunnen dat wel maar zijn dan net zo traag om tot dat antwoord te komen).

Je moet echt GPU's gebruiken en dat is jammer want daar is lastig aan te komen en geheugen is nu zo duur dat het echt een investering is. Bovendien gaan je energiekosten dan dermate omhoog voor machines die constant aan zijn dat het ook niet echt meer de moeite waard is om lokaal te draaien voor "af en toe" wat vragen.
In 128GB kan je een model kwijt wat je ook standaard krijgt bij een ChatGPT abo van €23/maand, met een machine van €3389 kan je dus 14 jaar een ChatGPT abo nemen.
Over 10+ jaar is dat abo wat nu 23 euro kost minimaal 5x zo veel en ben je niet in 5 dagen maar in 5 uur door je tokens heen :+

Uiteraard is er ergens een kantelpunt maar ik vind de gedachte wel te simplistisch, net als wel extra koeling voor de warmte benoemen maar niet de reductie in gasverbruik in de winter van diezelfde warmte, dat is gewoon een scheef beeld creëren...

[Reactie gewijzigd door watercoolertje op 1 oktober 2026 15:17]

Chatgpt is niet 23eu per maand. Wie veel code zoals ik bijvoorbeeld betaald 200 eu per maand en hit nog altijd de limieten constant. En dan praat je direct over 2400 euro per jaar wat ik standaard uitgeef. En sinds een paar dagen is de 200 euro abo gehalveerd in usage en is er een 500 euro abo bij gekomen. Dus ja. Ik ga switchen na deze maand. 200 maandelijks betalen vond ik eigenlijk al veel te veel, maar nu ren ik snel weg. Google komt precies op het juiste moment met een nieuw front tier model nu die goedkoper is en net zo goed als de nieuwste van GPT en Claude dus ik kan hoppen. Maar je eigen modellen kunnen draaien kosteloos is altijd de beste optie long term.
Komen er bij ChatGPT/Claude ook niet nog Tokenkosten bij?
Why? Alleen als je tokens gebruikt, dan is dat een nog slechtere deal! De oudere Frame Desktop zou ~30t/s doen met GTP OSS 120b, dat is maximaal 79 miljoen tokens per maand via inference als deze 24/7 draait (input is bijna 6x cheaper dan dat), dat is $13,43/maand aan output tokens, oftewel een euro of twaalf per maand. Wellicht meer met input tokens. Maar zo een machine draait niet 24/7 laat staan met stroom verbruik, je bent onder een constante AI load al veel meer geld kwijt aan stroom (meer dan tokens ooit zouden kosten, x2.5 de tokens).

Misschien is het wel een goeie om te kijken naar hoeveel tokens zo een machine uberhaupt per maand kan generen per model en dan kijken wat dit kost met een goedkope leverancier (check openrouter).

Zou je meer kunnen uitgeven dan dat, natuurlijk, maar dat is wat zo een Drame desktop oplevert.
je verdient dit natuurlijk nooit terug.

De AI modellen die je hier realistsch en comfortabler op kan draaien, zijnde GLM 5.3 Flash , deepseek v4.1 flash , Mimov2.6 flash en Qwen 3.8 flash kosten op openrouter tussen de 0.5 en 0.25 $ per million tokens.

Dus als je echt like for like wil dan zit ik met napkin math rekening houdend met 40 tokens per seconde output 9is wel haalbaar voor deze modellen en de strix) , dan zit ik met een terugverdien tijd van 4849 dagen of 13.3 jaar, zonder rekening te houden met electriciteit [ zo een 150w per uur] of tijd dat de box besteed aan compute van input.

Het voordeel van deze box is dat je bv ongecensureerde modellen kan lopen of kan finetunen naar je eigen noden. En natuurlijk de garantie dat alles lokaal is in totale privacy.

Lokale modellen halen wel de kwaliteit van cloud modellen maar niet die van de laatste frontiers opus/fable en astra's, maar die zijn ook aan de prijs en enkel de duurste abonnementen kunnen die aanspreken, het is ook niet economish om die modellen het volledige coding werk te laten doen, daar zijn ze te goed en te duur voor, je laat je project plannen door de frontier model en het daadwerkelijke werk door de deepseeks en qwens van deze wereld doen tegen een veel goedkopere prijs.
Local AI op deze dingen is niet top, GPU gewoon niet goed genoeg. Beter een DGX Spark.
Hebje daar meer info over?

Ik dacht dat ze qua inference min of meer gelijkwaardig waren. En dat enkel het cuda gedeelte onderscheidend was voor de dgx spark.

En dat dat dan weer vooral tot uiting kwam in het fine-tunen van modellen, en niet per se het gebruiken van modellen.

[Reactie gewijzigd door estej op 1 oktober 2026 14:46]

De 8060S is RDNA 3.5, die doet geen native FP4 - of zelfs native FP8. Dus, zeker voor MoE-modellen waarbij de experts tegenwoordig al native 4-bit zijn ga je heel snel nat qua performance.

https://www.techpowerup.com/gpu-specs/radeon-8060s.c4270

vs

https://www.techpowerup.com/gpu-specs/gb10.c4342

Nu is het zo dat aan allebei de kanten nog niet het maximale uit de hardware word gehaald, maar de matrix-performance getallen op bovenstaande links zeggen genoeg.

Tel daarbij nog bovenop dat je DGX Sparks wel kan clusteren doordat er een 200gbit NIC inzit - en dan is dit voor inference iig niet je geld waard, tenzij je echt helemaal niets geeft om snelheid en dat dus ook niet je primaire usecase is. Heb een strix halo, verder blij mee, als dev-box, niet als inference-box ;)

[Reactie gewijzigd door ufear op 1 oktober 2026 15:12]

En tov een Mac Studio dan?
Zelfde probleem, zelfs met een M5 Ultra, geen FP4/FP8 support. Al is de M5U wel ~3x zo snel als de M3U geloof ik.

De cijfers die je ziet zijn van mensen die boeken schrijven (lees, geen input, veel output verzinnen), of de LLM van 1 tot een miljoen laten tellen ofzo, en dat dan 'bruikbaar' noemen, fantasie. Echte workload is voornamelijk veel dingen lezen, niet perse schrijven.

Decode op de Macs gaat door de geheugenbandbreedte best rap; maar is door gebrek aan compute praktisch gelimiteerd tot 1 thread en schaalt niet lekker door (zover ik weet, zelf geen Mac!). Bij een spark schaalt het tot 4-8 redelijk door, bij de RTX kaarten tot 16, en bij de B300s van deze wereld kom je wel tot 64 voordat je de boel op 100% hebt draaien.

En bij sparks mag je stiekem de geheugen bandbreedte van alles in een cluster bij elkaar optellen, dus ik had tot een paar weken gezegd dat het qua prijs een beter idee was om 4 sparks te halen ipv 1 Mac; maar met de prijzen nu is dat wat minder appetijtelijk.
Hmm

IK zat te kijken naar een amd halo of een Mac Studio oplossing voor het lokaal kunnen vibecoden. En daarnaast inzetten als chat vervanger voor de rest van de fam thuis

Maar als ik jou begrijp zal daar de performance nog wel een van kunnen tegenvallen ?
DGX Spark is ook geexplodeerd in kosten. Ik heb recent een tweede gekocht naast m'n eerste, en die was bijna dubbel zo duur. Wel mooi met een mooie DAC en RDMA... VLLM schaalt daar mooi op, maar ook met valkey/celery en vision AI tools kun je tof dingen schaalbaar maken.

[Reactie gewijzigd door Umbrah op 1 oktober 2026 15:37]

Iemand die echt bezig is met local AI -> verdien je het prijsverschil eenvoudig / binnen afzienbare tijd terug?
Het is natuurlijk de vraag wat je probeert te verdienen. Is het puur geld of ook privacy? Als je 'on the edge' bezig bent met AI, dan loop je met de publieke modellen snel tegen 'guard rails' aan. Dat kun je met een lokaal model makkelijker omzeilen. Als je honderden euro's per maand aan tokens besteed, kan een lokaal model ook goedkoper zijn, maar niet direct ook sneller. En daar komt nog wel de stroomprijs bij, natuurlijk.

Je maakt in ieder geval minder taalfouten met AI. :P
Dan nog is op het moment de GPU gewoon een onzettende bottleneck. Kan je beter een Mac Mini/studio kopen. Kan je de volledige Qwen 3.8 27b versie op draaien dan. Dat is een best mooi model.

[Reactie gewijzigd door Zwarte_os op 1 oktober 2026 14:24]

die kun je toch prima draaien op de (oude) framework. Zie Ryzen AI Max+ 395 (64GB) resultaat. sudoingX/qwen38-mtp: One llama.cpp flag unlocks +33-39% decode speed for Qwen3.8-27B on consumer GPUs. The MTP head already ships inside your GGUF. Recipe, paired benchmarks, probe tool.

De Mac Studio M3 met 96 GB is ongeveer net zo snel, de Mac mini heb ik geen cijfers van.
Inderdaad, in eerste instantie dacht ik gaaf zeker omdat je het geheugen kan delen en gebruiken voor AI. echter is het te traag als je het prijstechnisch vergelijkt met een Mac Studio of zelfs Mac Mini.

Verder kan je er linux op zetten en is het beter te beheren als een Mac waardoor het zich beter leent voor server taken
Lokaal AI draaien (buiten eventuele hobby) doe je volgens mij toch vooral om data niet één of andere cloud in te jagen, niet omdat je dat zelf persé beter of goedkoper kan doen.
Zeker met deze hardware prijzen.

Als je bijvoorbeeld veel werkt met data van anderen kan je dat gewoon niet zomaar tegen ChatGPT of Claude aan kletsen.
Wel tegen een lokale machine.

[Reactie gewijzigd door Polderviking op 1 oktober 2026 15:18]

Dit is een oprechte vraag, maar ik snap echt niet wat men lokaal met zo’n machine doet. Hoe verdien je hier geld mee? Koopt men dit om het weer door te verhuren? Misschien is dit een interessante special voor Tweakers om eens uit te lichten.
Als je het toch kan betalen, kun je hier redelijk wat lokale AI mee draaien.

Ik zie het nut er ook niet van in, maar er zijn ook mensen die voor duizenden euros aan AI tokens uitgeven voor hun (alles behalve winstgevende) bedrijven of projecten. Dan is dit een betere deal
De vraag blijft natuurlijk hoe vergelijkbaar het is. Volgens mij zijn er geen lokale modellen die hier op draaien die ook maar in de buurt komen van een Opus 5.5 bijvoorbeeld.
Nouja nee, maar dan pak je ook meteen het meest geavanceerde model wat nu te krijgen is.

Zijn genoeg Chinese modellen in die klasse zoals Qwen 3.8 Flash-Next die best in de buurt komen, afhankelijk van wat je er mee doet. Of voor bepaalde taken kun je gewoon vele verschillende kleinere agents draaien.
Ik geloof dat Fable, Sol, en mogelijk anderen nog wel wat geavanceerder zijn, maar fair point.

Maar voor de 'mindere' modellen zijn de tokens ook een stuk goedkoper; en de performance die je hiermee haalt is denk ik niet optimaal vergeleken met de capaciteit van cloud modellen.

De enige echt goede reden is als je dingen lokaal wil houden denk ik.
Ik vind het erg interessant. Als ik zie wat men allemaal met Opus 5.5 doet dan ja ok. Als je dat thuis zou kunnen doen ja dan verdien je het wel terug.
Alles respect voor Framework, maar wat een bizarre prijzen hebben we toch.
Tja, maar daar kan framework ook niets aan doen. De normale componenten zijn nog steeds normaal gesprijst bij ze. Alleen de AIflatie gerelateerde componenten gaan inderdaad met de markt mee.
Daarom ook alle respect voor wat ze proberen te doen. Maar hun meerprijs word nu nog zo veel opgeblazen met de ai flatie. Ik vind ai nuttig zou er graag lokaal en draaien van de zonne panelen voor analyse taken die niet real time hoeven, maar de prijzen zijn gewoon niet leuk meer overal
AMD Ryzen AI Max+ PRO 495

Maar goed dat de kast nog een klein beetje formaat heeft, anders zou de sticker met de specs er nooit op passen.

Framework levert met deze series wel erg niet-upgrade-able systemen, of zie ik dat verkeerd?
Als je echt met AI los wilt gaan is het niet beter om een GPU te huren?
GPU(s) met 192GB VRAM gaat je toch behoorlijk wat kosten hoor, dat is 2 RTX 6000 Blackwells (aanschafprijs boven de 20k waarschijnlijk al :+ )
De prijs voor 1 enkele RTX6000 was recentelijk verhoogd van 8000 USD naar 160000 USD. Dank je, NVidia.

Deze kaarten komen ook pas tot hun recht in computers die zonder GPU al een prijskaartje hebben van 5000 USD. Dus 2 RTX6000 kaarten en een computer die daar mee om kan gaan, dan zit je al sneller aan de 40k USD dan je denkt.
Wat een bedragen. Het lijkt eerder op te lopen dan af te nemen. Vraag me af of en wanneer er verlichting gaat komen
volgens de CEO van Acer piekt 't halverwege 2027 en gaat 't dan langzaamaan dalen.
Dat zou geweldig zijn maar ik druf nog niet te hopen...
Even gekeken in Pricewatch : daar zijn 2 Tb TLC PCI-e 5.0 met Dram cache SSD's zo'n 350-400 euro. Reken je dan 200 euro voor de installatie en support van Fedora op de SSD : Dan is de prebuilt nog aan de dure kant tov de kale variant.

[Reactie gewijzigd door AtariXLfanboy op 1 oktober 2026 14:11]

Compute for the elite
ik wacht wel.

Ik wil wel een framework mini desktop voor homelab etc (ik vertrouw ze meer dan bijvoorbeeld een minisforum, puur gevoelsmatig). Maar m'n fried nuc vervangen mag echt nog even wachten op deze manier. :)
Beter een M5 Max 128GB of M5 Ultra 256GB.

Om te kunnen reageren moet je ingelogd zijn