GGUF is een bestandsformaat dat modellen in verschillende vormen kan opslaan BF16 is daar een van.
Zoals je weet is 'in 4-bit' in in het geval van A100 een 4-bit integer met 16 verschillende waardes, ... dat is een wereld van verschil met FP16 en BF16.
De grap is, dat is dus niet zo. Een Q4_K_S (of M/XL) of INT4 quant is niet alleen INT4. Per groep van bijv. 256 of 128 weights is er één FP16 waarde, die dient als reference voor de rest van de 4 bit waardes binnen het blok. Bijvoorbeeld alles keer 10 of alles keer 51,3. Whatever. Bij een Q4_K_S/M/XL quant komen daar nog meer waardes tussen die elk blok in sub blokken verdelen. Dat maakt dat je dichter bij een BF16 origineel zit, dan een "normale" INT4 of FP4, met voor een M of XL meer delen in hoge precisie.
Een NVFP4 quant is niet anders, de vier bits van NVFP4 zijn namelijk ook maar 15 verschillende waardes (want plus nul en min nul is hetzelfde

). Het verschil tussen INT4 en NVFP4 is dat je bij INT4 altijd stappen van 1 hebt, terwijl je bij FP4 kleinere stappen hebt in de buurt van nul en grotere stappen aan beide uitersten van de range.
Dus waar een weight bij INT4 altijd nul of één of 2, etc moet zijn, kan bij FP4 ook 0,5 en 1,5. Andersom, is het minimum en het maximum bij NVFP4 plus of min 6, en dan de volgende stap is 4. Vijf kan niet, 7 ook niet. Bij INT4 zou dat wel kunnen.
Zal er een verschil zijn tussen INT4 en NVFP4, zeker, maar een model dat genoeg heeft aan 15 verschillende waardes, zal doorgaans ook wel genoeg hebben aan 16 verschillende waardes. Je verliest iets, maar het is geen wereld van verschil.
GGUF met een Q4_K quant zal altijd ietsje dichter in de buurt komen bij BF16, maar met GGUF moet je elke berekening 2x terug rekenen om bij de originele waarde te komen, terwijl dat bij INT4 of FP4 maar één keer hoeft. Het is een soort LLM.zip of .rar, je bespaart ruimte, maar het kost compute om in te pakken en weer uit. Bij mijn 3090 is het verschil ongeveer factor 2.5 tussen een INT4 en GGUF 4 bit model in totale tokens per seconde.
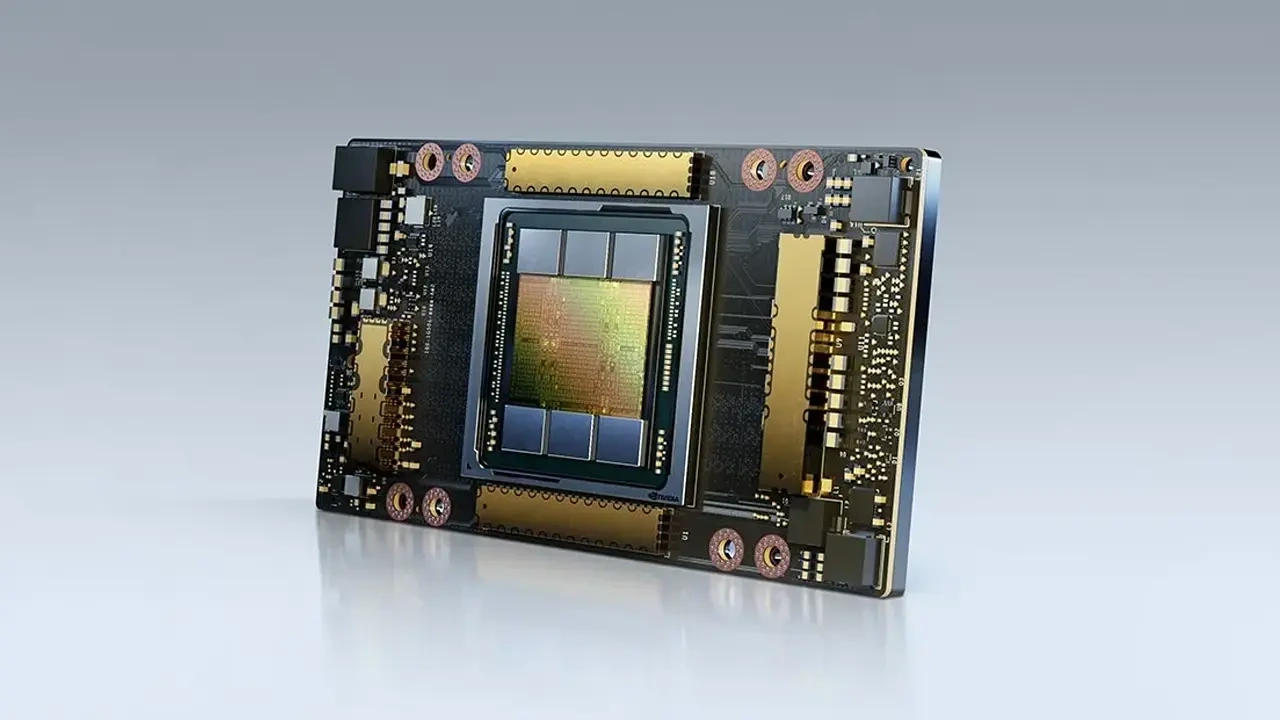
Ik zag pas een 14kW aansluitwaarde machine met 8 x A100 aangeboden voor de prijs van een DGX Spark dus vandaar dat ik toen wat berekeningen gedaan heb rondom efficiëntie en wat er op kan draaien.
Dat bleek minder dan een Spark te zijn voor dezelfde modellen.
Ja, maar je mist hier een beetje de open deur: de 8x A100 machine verbruikt 14kw. Dat ie vele malen krachtiger is dan een DGX spark, wil niet zeggen dat ie wint in de real world. Een DGX Spark kun je op je bureau neer zetten en gebruiken voor allerlei leuke AI projecten, met kleine tot middelgrote modellen, terwijl 8x A100 een machine is die je per uur meerdere euro's aan winst moet opleveren om alleen de stroom te betalen, laat staan de rest van het DC.
Modellen van 300 - 600 b parameters zijn leuk, maar dan moet je er echt wel een serieuze use case voor hebben en zeker weten dat ie lang genoeg relevant blijft om een nieuw datacenter uit de grond te stampen en je netbeheerder te vragen om een grote stroom aansluiting.
Overigens ik neem aan dat je bedoelt zelfde prijs per uur? Want een A100 is op ebay nu ongeveer 2500 euro waard, dus als je er acht kan kopen voor 5000 dan zou ik dat zeker doen.
De nvlink heeft inderdaad meer dan 1 lane, mijn indruk is dat niet meerdere lanes gebruikt worden tussen het geheugen van twee GPU's in de zin van parallelle data transport in een richtinb tijdens het uitvoeren van het model, maar ik heb geen A100's dus heb dat zelf niet getest.
In een systeem met 8x A100 zul je 6 nvlink switches hebben, met per switch 2 lanes naar elke GPU, dan kun je dus de hele bandbreedte gebruiken van één gpu naar elke willekeurige andere, met 4x A100 is het simpeler om naar elke andere gpu 4 lanes te sturen.
Dataoverdracht op een GPU is bijna altijd parallel over meerdere lanes. PCIE is ook bijv. 16 of 8 lanes en daar merk je als gebruiker niks van.