Nvidia RTX PRO 5500-gpu heeft 84GB geheugen en evenveel CUDA-cores als RTX 5090

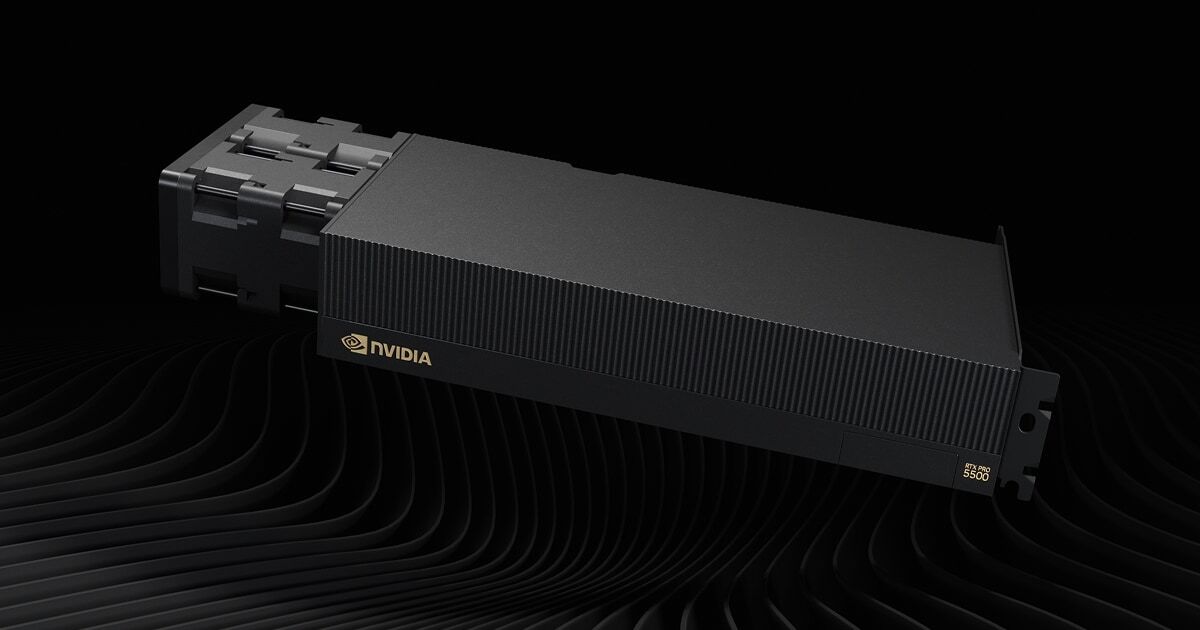
Nvidia heeft de RTX PRO 5500 Blackwell Workstation Edition onthuld. De AI-accelerator heeft 84GB GDDR7-geheugen met error-correcting code (ECC) en 21.760 CUDA-cores, evenveel als de RTX 5090. De tgp van de kaart bedraagt 600W.
De RTX PRO 5500
De RTX PRO 5500

De RTX PRO 5500 gebruikt volgens PNY een GB202-die met een 416bit-geheugenbus en een geheugenbandbreedte van 1398GB/s. Mogelijk klopt die informatie niet volledig: de GB202-gpu heeft in totaal zestien 32bit-controllers. Daarom zou het logischer zijn als de kaart een 448bit-geheugenbus heeft, zoals onder meer de RTX PRO 6000D. Dan zouden veertien van de zestien controllers actief zijn, met elk twee modules van 3GB om op de totale geheugenhoeveelheid van 84GB uit te komen.

Het geheugen op de RTX PRO 5500 ondersteunt ook ECC. Dat corrigeert automatisch fouten in data in het werkgeheugen om crashes te voorkomen.

De kaart gebruikt PCIe 5.0 x16 en biedt vier DisplayPort 2.1b-uitgangen. De RTX PRO 5500 ondersteunt ook Multi-Instance GPU. De kaart kan daardoor functioneren als één instance van 84GB of twee afzonderlijke instances van 42GB. Nvidia levert de gpu in uitvoeringen met lucht- of waterkoeling. Er zijn nog geen prijzen bekend.

CUDA-cores Geheugen Bandbreedte Tgp
RTX PRO 6000 24.064 96GB GDDR7 1792GB/s 600W
RTX PRO 5500 21.760 84GB GDDR7 1398GB/s 600W
RTX PRO 5000 14.080 48/72GB GDDR7 1344GB/s 300W
RTX 5090 21.760 32GB GDDR7 1792GB/s 575W

Door Imre Himmelbauer

Redacteur

15-09-2026 • 12:20

71

Submitter: Tundreq

Reacties (71)

Sorteer op:

Weergave:

Iemand een oude Qashqai (2012) kopen? 120k km op de teller, aftermarket Carplay en zo.

Kan ik mooi zo een kaart gaan halen dadelijk. :9~
Die grafische kaart heeft binnen no time een absurde hoge afschrijving door veroudering. Kortom een auto of grafische kaart zijn beide slechte investeringen.
Als ik een paar 5090s gekocht had voor 2300 euro en ze lekker in de verpakking had laten zitten dan was ik nu spekkoper geweest.

Hetzelfde voor RAM en opslag. Achteraf had je er een compete hypotheek in willen stoppen :+
inderdaad, dat dus.
Maar dat is altijd zo 'achteraf'

Ik had ook bijna 2500 euro liggen...

Daar had ik makkelijk een paar knappe SSD's voor kunnen kopen 'vorige jaar'
voor 110-120 euro.. dan had ik nu ook gewoon 'even' een 1800-2300 euro 'extra' kunnen verdienen met doorstoten

Ofwel mijn geld verdubbelen, daarvoor had ik wel 22 2TB SSD een jaar lang in de verpakking moeten laten liggen.

Of toch in september 2016 'even' voor 10 rooie een bult bitcoins kopen.. van 550 euro per coin.. en dan in september 2025 verkopen.. dus 'even' 10 jaar vergeten en dan 93.5K per coin cashen met 550 euro per coin inleg.. ofwel 1.69 miljoen winst draaien

Maargoed dat is ALLEMAAL achteraf... kijkt men een koe in de (....) tja...

[Reactie gewijzigd door MalamuteOC op 15 september 2026 14:54]

Grappig hé hoe je achteraf gemakkelijk rijk had kunnen worden? Vooral ook omdat deze methode gepaard gaat met 0 maatschappelijke bijdrage. Wat wij als maatschappij ook belonen. Zeer verstandig maar niet heus. Moest het even gezegd hebben.
zolang een maatschappij niet zorgt voor elkaar, hoef je dat ook niet voor de maatschappij te doen.

Als je je eigen schaapjes op het droge hebt, dan kan je kijken of je 'misschien' genoeg overhoud in deze alsmaar duurder wordende samenleving om 'misschien' wat bijdrage te leveren aan de samenleving.

Want werken EN belasting betalen is voor mij al genoeg 'bijdrage' imo.
Dat is best een trieste manier van samenleven of niet dan? Het was ook geen aanval op jou persoonlijk of iets degelijks mocht je dat denken. Ik vind gewoon dat het gezegd moet worden dat het totaal niet constructief is om dergelijke handel die nul maatschappelijke bijdrage levert zo beloond wordt. Wat mij betreft een design error die we eens een keer rap moeten oplossen. Dan hoef jij misschien ook niet zoveel belasting te betalen voor het werk dat je doet wat hopelijk, waarschijnlijk meer maatschappelijke bijdrage levert dan bijvoorbeeld handel in crypto of speculeren met GPU's.
Achteraf jammer, maar ik heb dus nooit een 5090 kunnen vinden. Had een budget van 2600 ervoor... maar dat bleek totaal niet haalbaar de eerste weken.

Toen maar een flagship 5080 voor 1800 gekocht toen ik er uberhaubt eindelijk één kon vinden die niet direct werd opgekocht.

Maar dat is nu al de 3e launch waar ik de FE kaarten in Duitsland / Frankrijk niet heb kunnen kopen. (NL zelf is al helemaal kansloos, amper 1% van de order aanmeldingen voldaan)

En dat is al met automatisering, hoewel een Distil setupje ondertussen allang niet meer onderscheidend is.

Heb uiteindelijk gewoon nooit een 5090 voor minder dan 2759 in het wild op voorraad gezien.
Ik had mij een doos DDR5 latjes van 2X32GB en 2X64GB gekocht. Kon ik nu al met pensioen gaan. :D
Een paar vrienden en ik hebben destijds aan de notify-me gehangen om 5090 FE's en een 5080 FE te bemachtigen. Met z'n tweeën hebben we in totaal 4× een 5090 in ons mandje gekregen en 1× een 5080. Ik heb de 5080 toen direct gekocht omdat het er op leek dat de 5090 niet ging lukken. Bij een drop een maand later dus toch nog twee 5090's kunnen scoren en de 5080 naar een vriend in Roemenië gestuurd voor MSRP.

We hebben inmiddels maar een wireview pro II aan de 5090's gehangen want holy moly wat is het erg gesteld. Ineens hangt er een $5k+ stuk hardware in je PC. Moet er niet aan denken dat 'ie affikt.

Soms denk ik "verdikkeme, had ik die andere twee ook maar doorgezet" maar aan de andere kan zou ik me bijzonder slecht voelen over meedoen aan scalpergedrag dus nah.
Binnen huidige tijd? Een kaart die voor 2000 dollar goede 1,5 jaar geleden op de markt kwam, nu een veelvoud is.. denk dat hier best wat 'lucratieve' investeringen op zijn gedaan.
Mja, ken zo iemand in New Mexico... Die heeft aanvankelijk 1 5090 FE weten te kopen. En daarna heeft hij nog 3 maal een AIB 5090 voor rond de adviesprijs weten te kopen (2500 USD)

Uiteindelijk heeft hij die kaarten een paar maanden terug verkocht (voor 4500 a 5200) en heeft in augustus ook z'n eigen 5090 maar weggedaan voor een 9070XT.

En van die winst een Nissan Skyline gekocht...

Ondertussen is m'n PC een jaar later gewoon flink gestegen in prijs. En dan heb ik ook nog eens teveel betaald voor m'n GPU toen die net uit was. Het is alleen maar heel even beter geworden en nu gewoon weer duurder.
Dat zal dan wel een base model Skyline zijn geweest want van 4x 2500 ga je bij lange na geen GTR van kopen

[Reactie gewijzigd door Turismo op 15 september 2026 16:31]

Niet zoveel verstand van welke modellen er allemaal zijn, het ding heeft nogal een groep fans in de VS. Maar het was een recente occasion van 2022 met niet al te gek veel miles erop. In ieder geval niet zo'n high end zeldzame van een paar ton nee. Eerder onder de 20 duizend.

Maar toch vond het wel grappig dat een "gelegenheids scalper en liefhebber" juist gezien de discussie precies dat deed; van GPU's naar auto ipv andersom.
Net zoals de 4090 die ik kocht voor 1800 euro, en dezelfde nu voor 3500 euro nieuw wordt verkocht. Als alle afschrijvingen zo zouden zijn.
M'n Nintendo Entertainment System is ook 5x over de kop gegaan.
Moest wel 30 jaar wachten.
Ligt er aan wanneer je hem gekocht hebt. Die RTX5090 is alleen maar duurder geworden. Prijzen zijn nu het dubbele, Ze zitten nu tussen de 5-6k maar ziet er naar uit dat ze zelfs naar de 8k gaan wtf.
Nouja, ik heb vorig jaar november een RTX 5070 gekocht voor 529 euro. Inmiddels is deze 809 euro. Op de 2e hands markt wordt er zo'n 700 euro gevraagd voor een gebruikt exemplaar.

30% rendement lijkt mij geen slechte investering. Had ik er maar 20 gekocht.
Valt mee, 4090s worden nog steeds voor boven MSRP verkocht.
Zo de plank misslaan en toch +1 Ik heb een 4090 uit maart 2023 aangeschaft voor 1990,- en die zou ik nu voor ca dezelde prijs via marktplaats kunnen verkopen. Auto’s gaat in no time een klap van de waarde af. Ik speel al die tijd al met groot gemak alles voor een bedrag wat je ook voor een 2 weken vliegvakantie naar één of andere uitgekauwde ovebevolkte “must see” plek op aarde had kunnen uitgeven.
Ik vrees dat je toch zal moeten opleggen dan.
Ik vrees dat als ik nog veel langer wacht de inhoud van de benzinetank meer waard is dan wat er omheen zit.
Lol, daar zul je niet ver mee komen. Ik gok dat je er MISSCHIEN een 5080 van kan halen, maar denk eerder een 5060.
Wat een specs geloof me dat dat aardig aan de prijs is vooral met die huidige prijzen, nu alles al duurder is geworden maar 84 gb geheugen met dezelfde specs als een 5090 er.

Kijk je kan er een aardig spelletje mee spelen.
Razendsnel, en reteduur. Maar wanneer je Model groter is dan 84GB? 160 GB? 320 GB? Dan heb je er 4 nodig. Het laat zien dat er een markt is voor de M5 Ultra Mac Studio. Met 512 GB Shared Memory is die waarschijnlijk net zo duur als deze kaart. True, de rekenkracht is duidelijk lager, maar bij hele grote modellen veranderd dat zeer waarschijnlijk (moeten we zien). Maar goed, wat voor model gaat gebruik maken van 512 GB shared memory? DeepSeek R1 671B INT4 bijvoorbeeld.

Interessant voor bedrijven die data niet naar de cloud willen sturen:
  • Contracten
  • Klantgegevens
  • Servicehistorie
  • Financiële rapporten
  • Productdocumentatie
Stel je gaat onderzoek doen (lokaal) naar bijvoorbeeld het betalingsgedrag van je klanten. Voorkom je 1 instinker van 25K en je hebt de investering er al uit.
Zijn daar de server gpu's niet beter geschikt voor als je modellen wilt trainen? Het flagschip nvidia gpu hiervan gaat tot 180gb hbm3.
Dat kan, maar wat kost dat? Lijkt mij niet iets voor on premise.
Amazon is ook niet goedkoop, je moet alleen wel een goede dekking hebben, beste is 100% gebruik, wat je on-prem niet haalt. Maar uiteindelijk betaal je in de cloud net zoveel of zelfs meer.
Bij consequent hoog gebruik van een resource is het goedkoper om het in huis te hebben. Behalve natuurlijk wanneer de kans groot is dat het stuk gaat. De cloud provider wil er natuurlijk wel aan verdienen bij het ter beschikking stellen van de resources.
Dat zou je zeggen, maar ze verkopen de tokens onder de kostprijs en dit soort reuzen krijgen de hardware ook veel goedkoper dan het MKB.

Je moet het lokaal hosten niet doen vanwege het geld, maar er zijn genoeg andere redenen natuurlijk.
Mja, GPU power is duur in de cloud, maar de hardware ook. De gespecialiseerde AI servers voor in het DC beginnen bij 400k instap, en 1=geen, dus dan zit je op 800k. Plus netwerk en datacenterkosten etc. Daar kun je een boel tokens voor aanschaffen. Juist als je niet concequent hoog gebruik hebt, maar desondanks wel veel regelmatig in een voorspelbaar ritme kun je waarschijnlijk een eind komen met twee DGX's of een Mac Studio. Maar ook dan, voor 10k kun je ook 4 jaar lang het grootste Claude Max abo aanschaffen.
Modellen kunnen redelijk eenvoudig parallel schalen in iets als VLLM. Een mac is leuk maar qua concurrency haalt het dat niet met een GPU, en als je agentic/multi model gaat werken loop je vrij snel tegen de grenzen van unified aan, namelijk dat het ook je gewone RAM is. Dit soort kaarten gooi je in een mooie Epyc 9575F gebaseerde bak (één CPU, geen NUMA gezeik), met 384GB multi-channel RAM, en laat je óf met 4 van deze kaarten in VLLM één model draaien, of je gebruikt die CPU en z'n eigen RAM ook en laat diverse modellen naast elkaar werken. Een paar kleinen (soms op de CPU) die bestanden zoeken/file management doen/dingen preppen/zoeken, paar MCP "deterministische tools" die niet AI/LLM zijn maar écht dingen doen (zoals HTML naar markdown renderen oid), paar testers, paar coders, etc...

Gezien de grote broer PNY RTX PRO 6000 Blackwell Server Edition: beste prijzen, echte reviews en specificaties - Tweakers 18k kost, en qua tokens/sec, en startup veel sterker is dan een mac, heb je eigenlijk gewoon een heel ander product.

Naast LLM's zijn er natuurlijk ook andere workloads, ik kan me niet voorstellen dat je op een mac lekker met CuPY aan de gang gaat om absurde hoeveelheden lidar/afbeeldingen te analyseren/verwerken. Er is meer AI dan alleen tekst/generatief immers.
Die M5 machines kun je ook parallel laten werken hoor. Als je er dan “maar” de helft geheugen, dus 256GB, in stopt dan maakt de M5 cluster nog meer kans om de wedstrijd te winnen.
Nahjah kijk, de M5 Ultra is zeker niet "slecht". 618GB/s bandbreedte met een dergelijke poel RAM is natuurlijk top. Maar we hebben het eens vergeleken met de HP Nano, beide met 128GB RAM. MLX engine werkt een stuk beter dan b.v. een llama model op de M5 architectuur. En dat terwijl de geheugenbandbreedte niet eens de helft is (275GB/s?)

Maar dan alsnog zit je op 32 tokens op de M5 en over de 200 op de Grace Blackwell hardware. Het moment dat je naar "te grote" modellen gaat, dus voorbij 27B of dat niveau + Reasoning, stort de Blackwell in naar 50 tokens per seconde, terwijl de M5 er één inlevert. Een stuk dichterbij.

De 5090 of PRO 5000 zitten daar met op de core 150+ tokens/s ook behoorlijk overheen. Alleen kan je dan hetzelfde grote model natuurlijk niet draaien. vLLM bf16 of nvfp4 geeft opeens een heel andere invulling, maar het dan met iets meer dan 100 tokens ook gewoon weer een heel ander soort product.

Natuurlijk, de Mac kan veel meer soorten dingen doen. Maar als je een paar duizend euro uit gaat geven aan een dergelijke oplossing, dan ga je niet ook eens wat video bewerken en een mailtje tikken op diezelfde hardware. En voor een niche oplossing, wil je uiteindelijk gewoon dé beste oplossing kopen. De scores van de M5 Ultra zijn zeker niet verkeerd, maar niet hier nog daar in de praktijk.
Je kunt die M5 machines zelfs koppelen via thunderbolt tot maximaal 4 tegelijk. Dan heb je 2TB aan video geheugen :D (en zo'n 60k armer).

Wil je 2TB aan video geheugen met de RTX PRO 6000 (met "slechts" 96GB) dan heb je 21 van die krengen nodig, dat is 400.000 euro voor alleen de videokaarten. Met de rest eromheen zit je waarschijnlijk tussen de 5 a 6 ton. Natuurlijk is dat sneller, maar het kost dan ook tien keer zoveel.
Hmmm zo makkelijk schaalt het toch echt niet. Zolang alles in het geheugen past, lees klein model, dan gaan die nvidia kaarten knallen voor je onprem setup. Maar voor 400GB+ modellen , dan zullen we nog moeten zien of de token/power/prijsratio in het voordeel van een Nvidia uitdraait. Want als je 4 van dit soort kaarten moet combineren om gewoon het model in geheugen te kunnen laden. :X

Die mac ultras gaan het voordeel hebben van veel, veel meer unified memory (512GB) en hebben ook al 1,3TB bandbreedte en zijn nog eens superzuinig ook

De toekomstige testen zullen het wel uitwijzen, maar mijn aanvoelen is dat wanneer je geen privacy bezwaren hebt je beter je workloads online kunt laten afhandelen en wachten tot de prijzen van hardware gaan afkoelen

[Reactie gewijzigd door klakkie.57th op 15 september 2026 15:46]

Dan ken je VLLM nog niet. Mooie K/V cache en letterlijk: weights splitting. Kan op zowel MoE expert-level, of weights/vector level. Maar één nadeel: werkt alleen met even splits. En het wordt al helemaal leuk (en daar kakt een mac écht vies in, want Apple heeft zo'n 15 jaar achterstand op de letterlijke "taal" van vectoren, nvFp4 is gewoonweg niet aanwezig bijvoorbeeld) als je zelf quantized, distilled, of: trained.

Nogmaals, ik vlak Apple niet af. Voor single user inference is het namelijk best wel de bang-for-bucks king specifiek op FP8 stijl taal/afbeelding modellen. Dit is namelijk eigenlijk niet compute bound, maar idd eerder memory bound. Zodra je iets doet waar compute ook bij kijken, dan is apple vooral een schattig stukje edge compute, en dan zal ik eerder zeggen: "gebruik de tooling, en de taal waar het ook op gebouwd wordt, en zet een DGX Spark neer, of voor mid size: een RTX Pro 5500/6000". Er is een reden dat B200 echter bestaat... en dat Metal eigenlijk ALTIJD later komt. Er zit wel wat werk op VLLM metal, maar dat loopt echt nog wel achter op de ontwikkelingen voor nVidia, of zelfs: RocM/Vulkan: GitHub - vllm-project/vllm-metal: Community maintained hardware plugin for vLLM on Apple Silicon · GitHub. Waarom? Het porten naar MLX is kut
Ik denk dat we allebei min of meer hetzelfde zeggen … alles heeft zo zijn usecase

Voor iedereen met interesse in deze materie, dit is een filmpje die het wat mij betreft heel goed uitlegt

YouTube: Cancel Your $200 AI Plan, Buy A $9,499 Mac?
Ik zal niet stellen dat er geen markt voor is, maar imo is het wel een overschatte markt. Er is meer dan geheugen hoeveelheid. De geheugen bandbreedte (die is niet laag bij de Mac, maar wel lager dan deze GPUs hebben ondanks dat er veel meer geheugen op zit), maar ook gewoon de ruwe rekenkracht. Als je niet puur memory limited ben in je model gaat dat ook een rol spelen. En nu ben ik geen expert of draaien van LLMs, maar ik vermoed zo dat die gigantische hoeveelheden GPUs die naast het geheugen worden verkocht is omdat je ook een hoop rekenkracht nodig hebt.

Kijk je naar FP4 dan gaat deze kaart een ~16x meer TFLOPS hebben. (FP16 4x). En ook integer is het verschil groot. (Let op, dit is gebaseerd op verwachtingen van het internet en niet harde data!).

Dus ja je kan een €25k in een lokale 'server' voor je LLM steken. Voordeel is dat je grote modellen een beetje kan draaien, nadeel zal zijn dat tokens / seconde gewoon erg beperkt is, en dus vooral zin heeft voor op de achtergrond wat doen. En ja controle van betalingsgedrag kan natuurlijk prima op de achtergrond.

Maar het grote ding imo: Hoe ga je in hemelsnaam die uitgave goed praten tov gewoon een abbo nemen bij één van de LLM boeren? Je wil het niet naar de cloud sturen? Elk bedrijf stuurt dingen de cloud in, je hebt gewoon een verwerkingsovereenkomst waar precies staat wat er met de data mag gebeuren. Heb je het nou over echt bijzondere data, bijvoorbeeld gezondheidsdata, dan zullen er nog meer eisen zijn. Maar contracten en klantgegevens? Dat is niet zo bijzonder. En zeker niet als we het hebben over MKB bedrijven.
Maar het grote ding imo: Hoe ga je in hemelsnaam die uitgave goed praten tov gewoon een abbo nemen bij één van de LLM boeren?


Niet.


Maar soms hoeft dat ook niet. Medische data die niet de [us] cloud in mag. -> lokale LLM!

Bedrijfs geheim? Idem ditto.

Bijna een nieuwe wetenschappelijkle ontdekking. Nobel prijs qualiteit? LLM, en oops, nu is LLM er eerder ondankts dat ze daarvoor 40% van een land zijn onderzoeks budget hebben uitgegeven aan tokens. Maar dat was toeval. Echt!


Conspiracy aside: Sommige dingen wil je *echt* niet publiek. En chatGPT & co betekend publiek.
Maar dat is dus mijn punt: Zo werkt het niet in de praktijk.

Specifiek het medische, daar moet beveiliging extra goed gedaan worden. Dus mogelijk kan dat niet naar een (US) cloud. Dus gebruik je een Europese / Nederlandse aanbieder van zulk soort cloud computing voor medische toepassingen. Dat is waarschijnlijk veel veiliger, goedkoper en betere performance dan maar zelf een servertje op je eigen LAN te plaatsen.

Maar goed, zoals ik al schreef, medische data is één ding. Maar bedrijfsgeheimen? Ik werk bij een grote multinational. Meeste van onze data staat allemaal in de cloud. Onze LLMs? Ja de eerste experimenten draaide lokaal want eng, maar tegenwoordig allemaal via de cloud. Als wij als grote multinational waarvan een hoop interessante data te jatten is het al gewoon in de cloud doen, waarom zou het gemiddelde MKB dat niet kunnen?
Conspiracy aside: Sommige dingen wil je echt niet publiek. En chatGPT & co betekend publiek.
Als je een enterprise contract hebt met OpenAI, en ze zouden (grootschalig) op die klanten spioneren, dan kan zouden ze de grond in geprocedeerd worden. Dan hoeft daar niemand zich meer druk te maken of AI een bubbel is of niet, hun assets kunnen gebruikt worden om de schadevergoedingen te betalen.
Ja, je kunt er grote modellen op draaien. Maar dat is dusdanig traag als poep dat je er buiten experimenteren geen klap aan hebt. Je hebt veel rekenkracht nodig. Een hoge gegevens doorvoer, en voldoende razend snel geheugen. Die Mac heeft 1 van de drie.
Probeer maar eens een model van 256 GB op die Nvidia RTX PRO 5500 te draaien, in een PC met 128GB en zie hoe snel dat dan is. De ketting is zo sterk als de zwakste schakel.
En dat voor slechts 23.588 euro (of zoiets) :)
Aangezien de 5090 praktisch uitverkocht is (https://www.tomshardware....0-for-nvidias-fastest-gpu) denk ik dat €23.588 een schijntje is.
Dat betreft online retail in de VS. Hier nog voldoende direct leverbaar. Uiteraard tegen een belachelijke prijs. :+

[Reactie gewijzigd door The Zep Man op 15 september 2026 13:32]

Tja, dit is weer zo'n gevalletje: Als je wilt weten hoe duur hij is, dan is hij niet voor jou :)

Maar inderdaad ongetwijfeld weer een astronomisch bedrag.
Gaaf! En kun je nu ook direct via Nvidia een tweede hypotheek afsluiten? :P

OT.. erg benieuwd wat dit allemaal gaat kosten. Ik werk zelf in 3D animatie, waar specifiek VRAM essentiëel is. Laten nou net al die kaarten onbetaalbaar zijn geworden (gelukkig voldoende GPU's voor de prijsverhogingen gekocht).

Hopelijk wordt met een een jaar (of twee) de markt weer wat stabieler, want gpu-rendering workstations bouwen is nu net zo duur geworden als een fatsoenlijke auto kopen.

Uiteraard kunnen renderfarms ingehuurd worden (die ook duurder worden overigens) maar om lokaal projecten op te bouwen zal toch hardware nodig zijn.
Nog beter! Als je beloofd er 1000 te kopen dan investeert nvidia in jouw kaartenhuis, en kun jij daarmee weer in hun kaartenhuis investeren. (al dan niet via nog een andere kaartenhuis of piramide)
Vertaling: NVidia verkoopt hun kaarten ook voor aandelen ipv geld, want ze hebben genoeg geld lmao.

[Reactie gewijzigd door ApexAlpha op 15 september 2026 12:58]

Wanneer kan je betalen met een nier ? :)
Of in je eigen garage of berging gaan wonen omdat het huis zelf onderpand is voor een grafische kaart. :+
Hypotheek dan al afbetaald? :?
Ah ja goed idee, dat ik daar nog niet aan heb gedacht.

Trouwens waar woon jij en welke bloedgroep heb je?
Maar als je echt professioneel bezig bent, dan is zelfs de huidige prijs van de 5090 nog steeds een goede investering, als jij langer moet wachtebln kost uiteindelijk meer.
But will it run Crysis?


Even serieus; Jeetje wat een specs! Ik weet dat het er niet voor bedoeld is maar ben wel benieuwd naar de game prestaties van dat ding 8)7
Tegenover de RTX5090 zal hij waarschijnlijk ietsje sneller, of gelijk zijn. Drivers zijn minder geoptimaliseerd voor games. In sommige benchmarks is de RTX6000 (met meer cuda cores) net wat sneller dan de RTX5090, dus dit zal wel aardig overeenkomen. Dat extra videogeheugen heeft vrij weinig waarde voor games.
Inderdaad. Ik heb redelijk wat grafisch zware en moderne games gespeeld, en nog steeds geen enkel spel tegengekomen dat meer dan 16GB VRAM gebruikt.
voor AI iig, aan de geheugensnelheid te zien is de pro 5500 niet sneller dan de 5090.

dat is voor AI, naast de hoeveelheid aan vram de 2de bottleneck.

meer vram = groter model in je geheugen kunnen laden

vram gb/s = hoeveel tokens/seconde je erdoorheen kan jagen.

5090 = 1.79TB/S
5500 = 1.39TB/S
ter vergelijking, van de vorige generatie de echte AI gpu in PCIE formaat:
H200 NVL = 4.89 TB/s
He lekker stukje duiding over de geheugencontrollers!
600W maar, those are rooky numbers
Nog even en je moet een melding maken bij mijnaansluiting.nl
🤯 Wat is jow use case voor 2 (!!) van deze GPUs?
En op welke wijze is het kopen van deze GPUs kosteneffectiever dan het gebruik van compute services in de cloud (e.g. AWS, Lambda Labs etc.)?!
Ik kijk niet naar kosten, alleen naar toepassingen.
OK als je dan gaat opscheppen, laat dan ook even weten wat die toepassing precies is waarvoor jij als particulier (ga ik vanuit) deze investering doet?
JENSEN: "Jonguhs, wat doen we met deze binned server RTX Pro 6000's uit Taiwan?"
MARKETING: "We plakken twee turbines aan de kont van de kaart en verkopen die voor een godsvermogen!"
JENSEN: "Kijk, daar kan ik een mooi lederen jack voor kopen"

Om te kunnen reageren moet je ingelogd zijn