AI-diensten moeten hun gegenereerde teksten sinds kort voorzien van een onzichtbaar watermerk. Daarmee moet achteraf te controleren zijn of een tekst door AI is gemaakt, maar de techniek is verre van waterdicht. Hoe werken die watermerken, wat merk je ervan en maken ze AI-teksten inderdaad slechter?
Dit was een lastige opgave. Het is namelijk onmogelijk om een AI-watermerk te integreren in een door een mens geschreven tekst. Maar in een verhaal over watermerken in AI-teksten is het te verleidelijk om te beginnen met een alinea die een watermerk bevat. Kun jij het watermerk in deze alinea spotten?
Sinds een paar maanden bevatten steeds meer AI-diensten ingebouwde watermerken in hun teksten. Die zouden voor mensen onzichtbaar, maar voor detectietools wel waarneembaar moeten zijn. Dat is niet vrijwillig, want de Europese AI-wet schrijft dat voor.
Die AI-watermerken zóuden voor mensen onzichtbaar moeten zijn, maar toch lijkt er wel enig effect te zijn. Veel mensen klagen al maanden over rare woordkeuzes van AI-diensten en wijten dat aan de watermerken.
Waarom een watermerk?
Kun jij het verschil zien tussen een AI-tekst en een menselijke tekst? De eerste jaren na het verschijnen van tekstgenerator ChatGPT eind 2022 was dat nog wel te doen, maar de veronderstelling is dat het steeds lastiger wordt om een menselijke tekst van een AI-tekst te onderscheiden.
De regel zit in artikel 50 van de Europese AI Act. "Aanbieders van AI-systemen, met inbegrip van AI-systemen voor algemene doeleinden, die synthetische audio-, beeld-, video- of tekstinhoud genereren, zorgen ervoor dat de outputs van het AI-systeem worden gemarkeerd in een machineleesbaar formaat en detecteerbaar zijn als kunstmatig gegenereerd of gemanipuleerd."

Aanbieders van AI wisten al een paar jaar dat de AI Act eraan kwam. De tekst is al jaren definitief en de regels gaan stapsgewijs in. Deze regel werd in augustus dit jaar van kracht.
De regel geldt niet altijd en overal. "Deze verplichting is niet van toepassing voor zover de AI-systemen een ondersteunende functie voor standaardbewerking vervullen of de door de gebruiksverantwoordelijke of de semantiek daarvan verstrekte inputdata niet substantieel wijzigen, of wanneer het bij wet is toegestaan strafbare feiten op te sporen, te voorkomen, te onderzoeken of te vervolgen."
Een watermerk is dus alleen verplicht bij het genereren van teksten, maar als de AI-dienst de input niet enorm wijzigt, dan hoeft het niet. Ook AI van bijvoorbeeld politiediensten is dus uitgezonderd van de regel. De gedachte is dat het watermerk de opsporing in de weg zou kunnen zitten.
Er is nog een uitzondering: als het geen AI-dienst is. Dat geldt bijvoorbeeld voor modellen die mensen thuis lokaal draaien. De gebruiker zelf is geen aanbieder van een AI-dienst en hoeft dus niet aan de wet te voldoen.
Volgens de Europese Commissie moet het watermerk erin zitten, zodat gebruikers kunnen zien of AI een tekst heeft gemaakt. De wet schrijft voor dat het 'machineleesbaar' is, dus het moet controleerbaar zijn. De regels moeten transparantie over het gebruik van AI bevorderen en daardoor het vertrouwen van mensen in AI versterken, zo redeneert de Commissie. De handhaving van de AI Act is inmiddels begonnen.
Hoe werken de watermerken?
Het menselijke watermerk in de eerste alinea is simpel. Ik heb de woordkeuze en woordvolgorde van de zinnen zo aangepast dat, als je het eerste woord van de eerste zin, het tweede woord van de tweede zin, het derde woord van de derde zin en het vierde woord van de vierde zin achter elkaar zet, de zin 'dit is een watermerk' ontstaat.
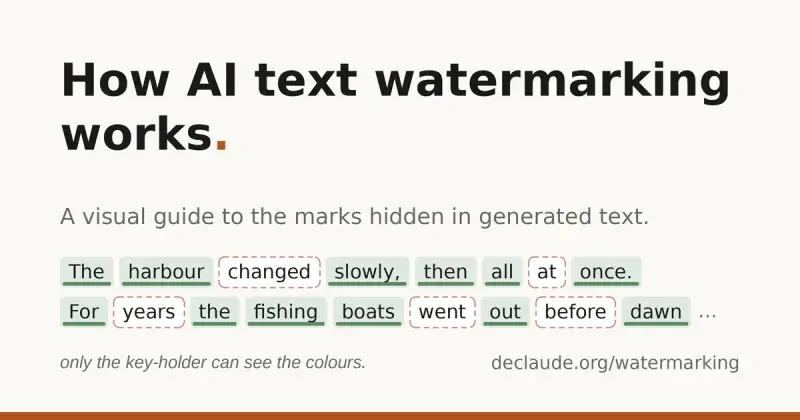
De watermerken voor AI zijn ingewikkelder en werken anders, maar het idee is hetzelfde. Als je precies weet hoe je moet kijken en de sleutel hebt, kun je het patroon ontdekken in de tekst en detecteren dat er een watermerk in zit.
Google DeepMind was pionier op dit gebied met SynthID, een detectiemethode die nu ook in Gemini zit. Het werk is te lezen in een paper die in het gezaghebbende blad Nature is gepubliceerd.

Het systeem werkt met woordenlijsten als sleutel. Bepaalde willekeurige woorden krijgen een kleine boost in het AI-model, waardoor de kans groter is dat het AI-model die kiest in een lopende zin. Detectiesoftware kan zien welke woorden die boost hebben gehad en kan dus nagaan of die woorden vaker voorkomen in de tekst. Het idee is dat mensen niets merken van SynthID, omdat beide mogelijke woorden even logisch klinken. Dat heet toernooisampling, of tournament sampling in het Engels.
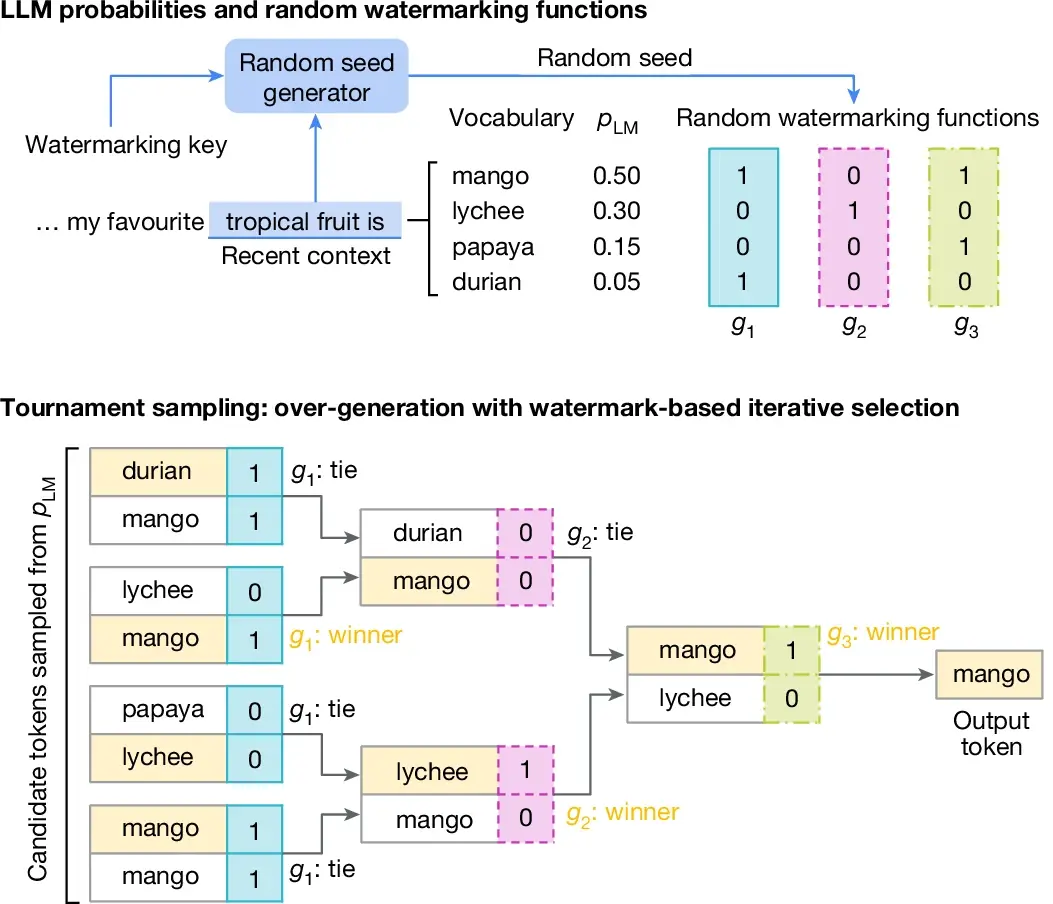
Anthropic gebruikt voor Claude een variant van SynthID. Welk synoniem Claude als output geeft, wordt dan bepaald door een random number generator. Die rng is ontworpen door Anthropic zelf en werkt met een sleutel. Het watermerk gebruikt die sleutel en een aantal voorspellingen in de tekst om te kijken of de gegeven woorden daar inderdaad zijn gekozen door de rng. Hoe vaker dat gebeurt, hoe groter de zekerheid dat de tekst inderdaad door Claude is geschreven.
OpenAI heeft textGrain gemaakt voor ChatGPT. Het systeem heeft dezelfde uitwerking, maar het algoritme is anders. Het gebruikt geen toernooisampling, maar optimaal transport, of optimal transport. Dat algoritme kijkt niet naar individuele woorden, maar naar grotere blokken als geheel. Het systeem bekijkt de output zonder watermerk en met een watermerk en probeert de tekst optimaal om te zetten zonder ingrijpende wijzigingen.

Een ander verschil is het entropiebudget. OpenAI lijkt veel bezorgder dan Google over het risico dat een tekst onmogelijk om te zetten is. Bij heel feitelijke prompts is het daarom niet wenselijk om een watermerk aan te brengen. Een feitelijke vraag als 'Wat is de hoofdstad van Groningen?' vereist een feitelijk antwoord. Met het entropiebudget kiest het algoritme er dus voor om vaker geen watermerk aan te brengen als de output te feitelijk of te kort is.
De systemen werken net anders. Belangrijker is dat ze aparte detectors nodig hebben. Een detector voor SynthID werkt daardoor niet automatisch voor teksten van Claude of ChatGPT. Dat maakt het gebruik natuurlijk onhandig, want als je wil weten of AI een tekst heeft gegenereerd, moet je hem door meerdere detectors halen. Hier komen vast oplossingen voor, maar een keuze voor één watermerksysteem was makkelijker geweest.
Een opvallende afwezige is Mistral. De Europese maker van AI-modellen heeft de regels nog niet geïmplementeerd. Of en wanneer dat gaat gebeuren, is onbekend. Het bedrijf zal dat op een gegeven moment natuurlijk wel moeten doen.
Watermerken komen ook voor in foto's en video's. Daarin zijn ze om verschillende redenen eenvoudiger toe te passen. Zo kun je beelden makkelijker onzichtbaar aanpassen dan tekst.
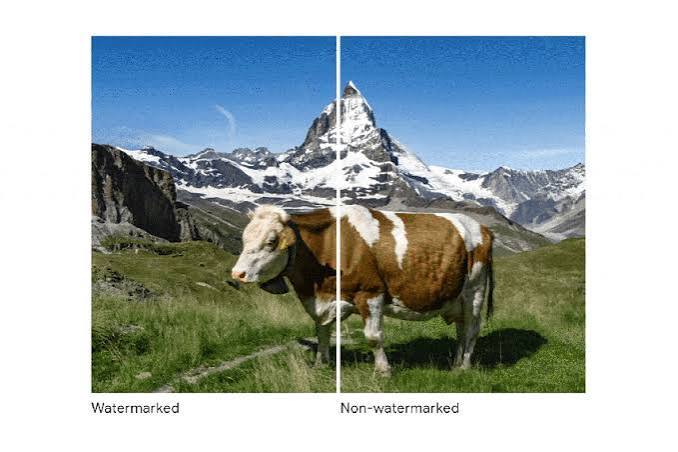
SynthID, dat de meeste AI-diensten gebruiken voor beeld en audio, werkt met het toevoegen van een specifiek ruispatroon in het beeld. Dat gebeurt met een versleuteling na het genereren van het beeld, waardoor SynthID met alle modellen kan werken. Het systeem bevat ook een ingebouwde decoder om te zien of het watermerk er inderdaad zit. Door de vele pixels in de meeste beelden is het watermerk nog te achterhalen als gebruikers het beeld bijsnijden, bewerken of opslaan in een ander bestandsformaat.
Watermerken hebben gebreken
Alle systemen hebben gebreken. Het belangrijkste is dat er een lap tekst nodig is om het watermerk aan te brengen. In een korte alinea werkt het niet. Daardoor bevatten veel teksten geen of een zwak watermerk. Bovendien is er alleen de vrijheid om een watermerk te plaatsen als het AI-model uit meerdere passende woorden kan kiezen. Als een tekst strakker is, is het watermerk niet of nauwelijks aanwezig. Dat geldt bijvoorbeeld ook voor code.
Daarnaast zijn detectors zelden honderd procent zeker. Een tekst is vaak 'waarschijnlijk AI' of 'waarschijnlijk menselijk', maar er blijft door de opzet van het systeem altijd een minieme kans op valsnegatieven of valspositieven. Daar komt bij dat lang niet alle AI-teksten wereldwijd een watermerk hebben. OpenAI past het alleen toe in de EU en via de api is het vooralsnog optioneel. Mistral heeft het niet, net als Chinese modellen zoals DeepSeek en Kimi. Dat maakt detectie al minder nuttig.

Een watermerk in beeld is lastig te verwijderen, maar vertalen vernietigt het watermerk in AI-teksten in veel gevallen al. Omdat vertaalsoftware, of dat nu een AI-model is of niet, ook woordkeuzes maakt, is niet meer te achterhalen wat de originele keuzes waren.
Tot slot is er een zachter, nog nauwelijks gemeten effect. De watermerksystemen zouden geen merkbare gevolgen moeten hebben, maar veel gebruikers melden toch dat de kwaliteit van de teksten sinds de invoering van watermerken achteruit is gegaan.
Dit is dus een imperfecte oplossing. Het is in elk geval wel een eerste stap om AI-content makkelijker herkenbaar te maken. AI-diensten gaan een interessante tijd tegemoet als de Europese Commissie overgaat tot handhaving van de AI Act, omdat ze lang niet allemaal voldoen. AI-output met een watermerk zal in elk geval steeds normaler worden, of wij het nu kunnen opmerken of niet.
Redactie: Arnoud Wokke • Eindredactie: Monique van den Boomen


