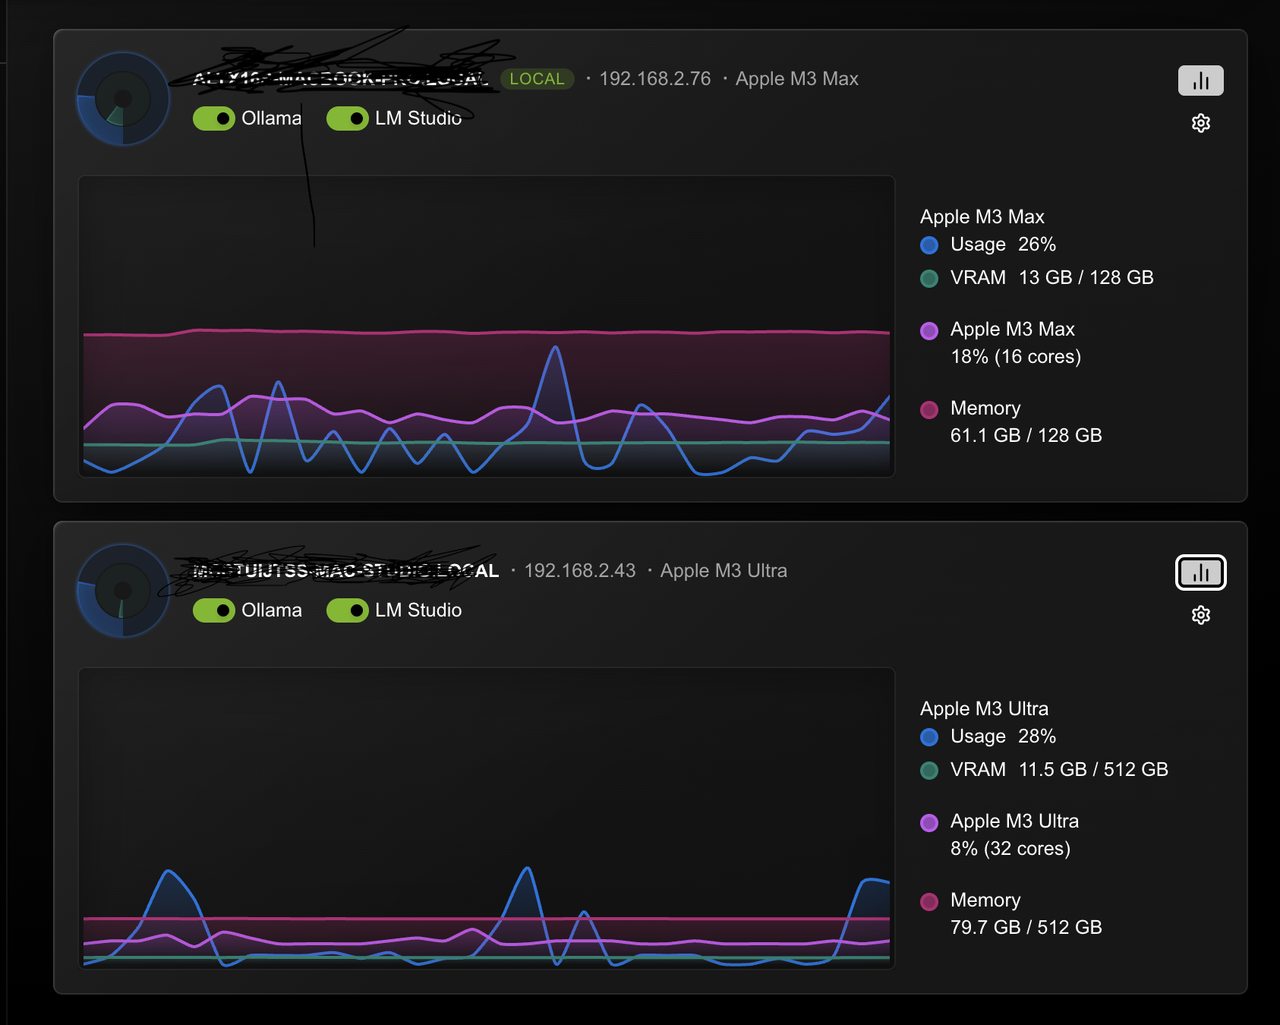
Zelfs Apple-chips kunnen meedoen in lokaal AI-cluster van Nvidia's PAIR

Nvidia komt met Personal AI Router (PAIR): opensourcesoftware waarmee apparaten op een lokaal netwerk kunnen samenwerken aan AI-taken. Dat werkt niet alleen met GeForce-kaarten, maar ook met andere gpu's of socs. PAIR is nu beschikbaar om te downloaden als bètaversie.

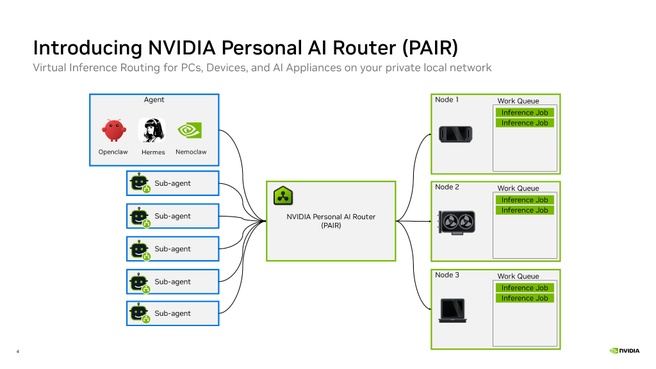
De PAIR-software herkent apparaten met AI-rekenkracht op een lokaal netwerk. PAIR verdeelt vervolgens een AI-rekentaak over die apparaten en houdt daarbij rekening met de rekenkracht van iedere gpu. PAIR kan gpu's ook even met rust laten als ze al in gebruik zijn, bijvoorbeeld voor gaming.
Nvidia PAIR

PAIR is compatibel met Ollama en LM Studio. Die programma's draaien nog steeds het AI-model. PAIR dient alleen als router. Nvidia ziet vooral toepassing in workflows waarin een AI-agent een taak opsplitst in meerdere subagents, die elk een deel ervan afhandelen. Met PAIR kunnen meerdere agents parallel draaien, wat tijdwinst moet opleveren ten opzichte van één systeem dat de agents na elkaar laat werken.

Ook andere gpu's mogen meedoen

De gpu's die via PAIR worden aangesproken, kunnen Nvidia's RTX-videokaarten zijn of een DGX Spark. Ook een gpu of soc van een ander merk kan meedoen in een PAIR-cluster. Nvidia noemt specifiek een Apple M4-soc of een nieuwer model. Met Nvidia-hardware werkt het in ieder geval vanaf de RTX 20-serie.

Nvidia PAIR
Screenshot van de PAIR-software die een taak verdeelt

Op basis van de herkende apparaten zijn gpu's voor AI-rekentaken aan een cluster toe te voegen. Gebruikers kunnen er ook voor kiezen om bepaalde apparaten in het netwerk uit te sluiten. Nvidia heeft PAIR vooralsnog getest met achttien gpu's. Er kunnen in theorie nog meer kaarten samenwerken.

Nvidia PAIR is nu beschikbaar om te downloaden. Het gaat voorlopig om een bètaversie. Het programma kan draaien onder Windows 11, Ubuntu, DGX OS (op Nvidia's eigen DGX Spark) en macOS.
Door Friso Weijers

Redacteur

04-09-2026 • 16:32

31

Reacties (31)

Sorteer op:

Weergave:

Kan iemand mij uitleggen wat het punt hier van is als je niet een model op kan splitsen? Heel veel heel erg kleine modellen draaien? Want op de gemiddelde RTX gaming GPU ga je niet veel soeps draaien tenzij je een 5090 ofzo hebt
Dat staat letterlijk in het artikel: "Nvidia ziet vooral toepassing in workflows waarin een AI-agent een taak opsplitst in meerdere subagents, die elk een deel ervan afhandelen."

Elke subagent kan op z'n eigen GPU draaien.
Nee, AI agents draaien niet op GPU's, die draaien gewoon in een proces op een CPU (linkerkant van het eerste screenshot). Wat hier gebeurt is dat alle GPU nodes LLM's draaien voor inference, PAIR routeerd (load balanced eigenlijk) de inference verzoeken over individuele GPU nodes.

In het screenshot zie je bijvoorbeeld meerdere nodes die allemaal hetzelfde model draaien. Het voordeel is simpelweg dat je een hogere doorvoer kan realiseren (in Tokens/Sec).

Veel "agentic" tools zoals Claude Code in ultramode, Kiro crew etc. knippen een taak op, en spawnen sub agents (child processes) die allemaal tegelijkertijd hun inference verzoeken doen (in plaats van een enkele agent die het sequentieel afhandeld).

[Reactie gewijzigd door Jay-v op 4 september 2026 17:03]

Ok, jij je zin: agents draaien op de CPU maar hebben een LLM die bij voorkeur op een GPU draait nodig. Verschillende agents hoeven niet eens per se allemaal dezelfde LLM te gebruiken: Claude code laat soms ook een agent op een beter model los om lastige vragen te beantwoorden. Uiteindelijk is het gewoon een kwestie van de duur betaalde hardware zo maximaal mogelijk in te kunnen zetten.
Nee, AI agents draaien niet op GPU's, die draaien gewoon in een proces op een CPU (linkerkant van het eerste screenshot).
Nee... AI agents draaien niet op CPUs, ze worden dar verwerkt... ;)
De gemiddelde taak die een agent zal uitvoeren werkt prima op een klein model draaiend op een willekeurige machine. 10GB VRAM is voor enorm veel taken meer dan voldoende
Dat hangt er van af hoe je AI inzet. Voor meerdere iteraties van afbeeldingen of video-sequences kan het handig zijn. Overigens heb je (nu al) niet per se een RTX 5090 nodig om toch wat leuks (qua afbeeldingen of video) te kunnen maken, kijk maar 'ns in dit topic.
Kijk verder dan je eigen usecases. Het is een AI router, om AI taken te routeren naar de juist AI voor de taak.
Er zijn systemen die een llm in lagen kan verdelen over meerdere processoren. Kijk maar eens naar Jan.ai daar heb je de mogelijkheid je grafische processor en cpu allebei te gebruiken om de 'lagen' in een llm te verdelen. Je kunt je voorstellen dat je dat over een netwerk kan doen.
Ik ben er even mee aan het spelen geweest. Op zich best leuk dat je taken over meerdere pc's worden gesplitst. Jammer dat er nog geen distributed heterogeneous inference in zit die taken netjes over verschillende modellen kan verdelen. Ik heb nog 2 aardappel pc's die best willen meedoen, maar niet zwaar genoeg zijn voor het grotere model. Daar zou ik graag ene kleiner model opzetten voor de lichte taken. Zou dan ook leuk worden voor offline kantoor omgevingen die geen dikke AI machine willen neerzetten.
Zouden ze hier ook consoles als ps5/xbox series X aan kunnen toevoegen? Als die staan te slapen is het een extra Ai node..
Niet tenzij Sony of Microsoft er aan meewerken, of je die dingen kan jailbreaken natuurlijk. Verder zijn het gewoon computers, hoewel niet bepaald erg krachtige naar hedendaagse maatstaven (hoewel ze wel snel shared memory hebben wat wellicht handig zou kunnen zijn voor ai).
Dus mijn M3 Ultra mag niet mee doen?

Edit: ah toch wel

[Reactie gewijzigd door Yzord op 4 september 2026 17:52]

Klinkt idd raar, M3 ultra is altijd krachtiger dan M4 of M4 Pro, lijkt mij... Zou er iets in het design veranderd zijn vanaf de M4 generatie?
Ergens generatie igpu in apple silicon is ook hardware AI compute toegevoegd. Dus niet alleen NPU. Is dat de M4 architectuur wel heeft en de wat M3 mist. Heb ik ergens gelezen. Weet het niet zeker.
Moet gewoon werken, de source code checkt niet op het model. Waarschijnlijk gewoon niet gevalideerd met een ouder model.
Volgens mij is dit hetzelfde principe als io.net, maar dan in het klein.

[Reactie gewijzigd door Faloude op 4 september 2026 17:38]

Als je Apple noemt, noem dan ook oMLX. Bij uitstek de software om efficient modellen op een Mac te draaien, zeker bij zaken met veel context-switches zoals agentic taken (inclusief coding).
Maar kan Nvidia PAIR er mee samen werken? Ik kom dat op de gelinkte site niet tegen, dus is vermoed van niet. Ik kom slechts Ollama en LM Studio tegen
oMLX heeft Ollama- en OpenAI-compatible endpoints dus het moet gewoon werken.
Ik ben zelf geen Apple gebruiker, maar dat is goed om te weten.
Nvidia en open source in 1 zin. Wouw
Zelfs Apple-chips kunnen meedoen in lokaal AI-cluster van Nvidia's PAIR
Apple is top op het gebied van lokale AI en werkt daarin ook al jaren samen met Nvidia. Apple heeft bijvoorbeeld voor eigen silicon ontwikkelde software geport naar Nvidia hardware en die software wordt ook door Nvidia gebruikt. Op dat lokale hardwardware concurreren ze niet dus dat PAIR ook op Apple chips werkt is niet zo verbazingwekkend.
FWIW, het draait ook op Windows 10, net even getest tussen een PC en Mac met een M4
Ach ik draai 200B+ modellen op mijn 2x M5Max’ (Qwen flash next/DeepSeekv4 en GLM 5.3 flash) over TB5 aan 40+ t/s met een Msty Nexus router naar dat model en een kleiner model voor creative writing en cloud model voor de enkel de planning alles automatisch … de 2x DGX sparks die staan stof te vangen ze zouden prima kunnen werken maar de 3 modellen van vorige weken hebben allemaal andere settings / inference engine recipes en teveel ge kut en zet ze maar eens dan nog in een cluster … heb het allemaal wel ingeregeld maar de Mac is klik and go en de DGX gaan in de verkoop M5U gaat gaan perfect mee in cluster kunnen met de 256GB die ik nu op de 2 zaken heb draaien.

NVIDIA is top in data center, maar ze zien de bui van on device AI hangen en willen dat ook afdekken, slim van ze …

Om te kunnen reageren moet je ingelogd zijn